高光谱图像分类实验
参考论文 *[Hyperspectral Image Classification via kernel sparse representstion][1],实现基于核方法(kernel)和稀疏表示(sparse representation)的高光谱图像分类算法。本文大致介绍论文中的方法和代码实现。文章是5、6年前提出的了,个人不是很了解最近这个方面最新的发展,似乎也有基于深度网络的分类算法出现。但从被引情况看这篇文章应该比较经典,而且从练手的角度看,实现核与稀疏表示这些经典方法相较于再套用一下神经网络也更有意义,因此实现其方法并简单介绍。
方法介绍
高光谱图像
高光谱图像(Hyperspectral image)相较于传统的 RGB 图像有更多波段的信息。RGB图像有红绿蓝三个波段的信息,于是它的数字图像可用 row x column x 3 的 tensor 表示;而高光谱图像可能包含几百个波段上的信息,比如某高光谱图像包含200个波段信息,那么它的大小为 row x column x 200 。高光谱图像的这些波段包含了许多RGB图像中没有的信息,因此它可以用于图像中的物体分类和目标检测等很多任务。本文就介绍一种基于核与稀疏表示的高光谱图像内区域分类算法。
高光谱图像的分类
假设有一个高光谱图像,它的波段数为$B=200$。那么图像中一个点可以用一个200维的向量$x\in R^{B}$表示,整张图像包含 row x column 个这样的列向量。有监督分类任务中有部分点的类别信息已知,要设计算法使用这些已知类别的点来预测未知类别点的类别。实验中使用印第安农场的高光谱图像,它包含了所有需要预测的点的各个波段的信息和类别(Ground Truth),我们从中挑选出10%的点作为训练点,另外90%的点用于test评估算法性能。
高光谱图像的稀疏表示
假设我们现在有 N 个训练数据点,用矩阵 A 表示这些点的集合: $A = [a_1,a_2,\cdots ,a_N] \in R^{B\times N} , a_i \in R^B$ ,其中 $a_i$ 表示第 i 个训练点。那么图像中任意一个点可以用这些训练点的线性组合表示:
$$
\begin{align}
x & \approx \alpha_1a_1+ \alpha_2a_2 + \cdots + \alpha_Na_N \\
& = A\alpha
\end{align}
$$
其中 $\alpha \in R^N$ 为稀疏表示的系数向量,之所以叫稀疏表示,是因为系数向量$\alpha$这个N维向量中绝大部分元素都是0。也就是说,只要用少量训练数据点的线性组合就能很好地还原任意点的信息。截图直观地了解这种表示: 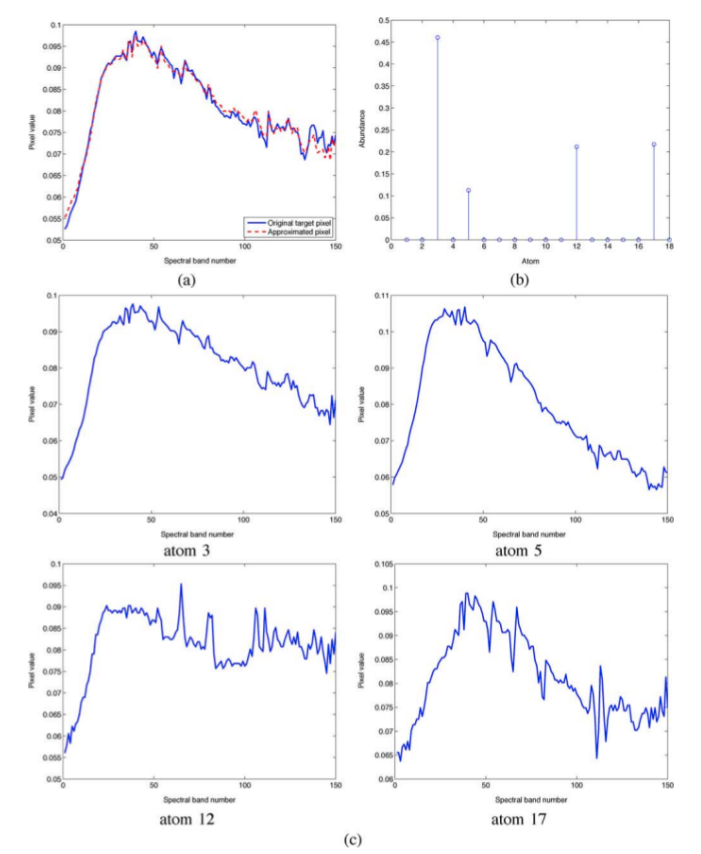
图中左上红色表示稀疏表示的近似,下面四个是用于近似测试点的训练点,可见只用了四个训练点就很好地还原了一个测试点的光谱信息。
我们需要寻找合适的方法来找到每一个测试点的近似信息,使得使用较少的训练点的线性组合来较好地还原测试点,对于任意一个测试点 $x$ 可以用如下式子表示:
$$
\alpha = argmin||x-A\alpha||_2 \\
s.t.||\alpha||_0 \le K_0
$$
其中 $||\alpha||_0$ 表示系数向量 $\alpha$ 中非零元的个数,也叫 sparse level。也就是说:使用训练点中少于 $K_0$ 个点的线性组合来尽可能准确地还原测试点。这个最优化问题的解法就是本文开头文章的核心算法。文章中给出了两种基于贪心算法的优化方法: OMP 和 SP ,这里仅实现第一种算法的代码。
对于某个测试点,有了上面提到的稀疏表示,我们就可以直接预测该点的类别了。既然测试点可以用一些训练点的组合来表示,那么很自然地认为稀疏表示中用到的某一类的测试点个数越多就代表它和该类越接近,也就属于该类。更精确一点:仅用 $\alpha$ 中某一类的值来表示测试点,那么如果该表示相比于仅用其他类表示时和测试点的差距最小,那么可以认为测试点属于该类:
$$
Class(x) = argmin_{m=1,\cdots ,M}Res \\
Res = ||x-A_{:,\Omega_m}\bar \alpha_{\Omega_m}||_2
$$
其中 M 为总类别数,$\bar \alpha$ 表示 $\alpha$ 中的非零部分, $\Omega_m$ 表示用于稀疏表示的线性组合中实际使用到的训练点中属于第 m 类的下标。
方法的基本结构就是上面提到的那样了,其实这种方法类似 KNN ,使用稀疏表示构造出了某种测试点到各个类的距离,然后直接按照这种距离判断类别。
核方法
核方法用于通过函数 $\Phi(x)$ 将低维特征映射到高维,从而将线性不可分的问题转换称线性可分问题。这里引入该方法应该是为了提高分类性能。 $\Phi(x)$ 通常较难计算,但在计算中通常会归结成需要计算函数 $\Phi(x)$ 之间的内积,而这种内积通常可以用核函数表示: $k(x_i,x_j)=<\Phi(x_i),\Phi(x_j)>$ 。也就是说不用先计算映射函数 $\Phi(x)$ 再算内积$<\Phi(x_i),\Phi(x_j)>$, 而是可以直接使用原特征 $x$ 计算核函数,就能得到上面要计算的内积。实验中用到 RBF 核: $k(x_i,x_j)=exp(-\gamma||x_i-x_j||^2)$ 。
z实验中通过核函数将数据点 $x$ 映射到高维,计算中原来向量 $x$ 之间的内积需要使用核函数来代替,具体的细节可以参考论文和代码,这里不再赘述。
近邻信息
考虑到该分类任务中同一类别的点会集中在一起,即相邻的点很有可能属于同一类别。那么相邻的点在使用稀疏表示时就可以不各自使用不同的训练点表示,而是使用相同的一组基和不同的系数来表示:
$$
X=[x_1,x_2,\cdots ,x_T]=[A\alpha_1,A\alpha_2,\cdots, A\alpha_T] \\
=AS
$$
在分类某一点$x$的类别,寻找稀疏表示时,不是优化这一个点的稀疏表示,而是把以该点为中心周围的 T 个点的稀疏表示作为目标优化,从而考虑了邻近信息。实验中会发现这种方法会给分类效果带来很大提升。不过使用了近邻信息也会带来弊端:边缘分类效果变差、较小的区域分类不好。
$$
\bar S=argmin||X-AS||_F \\
s.t.||S||_{row,0}\le K_0
$$
判断类别的表达式变为:
$$
Class(x)=argmin_{m=1,\cdots ,M}||X-A_{:,\Omega_m}\bar S_{\Omega_m,:}||_F
$$
$||x||_F$ 表示 Frobenius 范式。
正交匹配追踪OMP
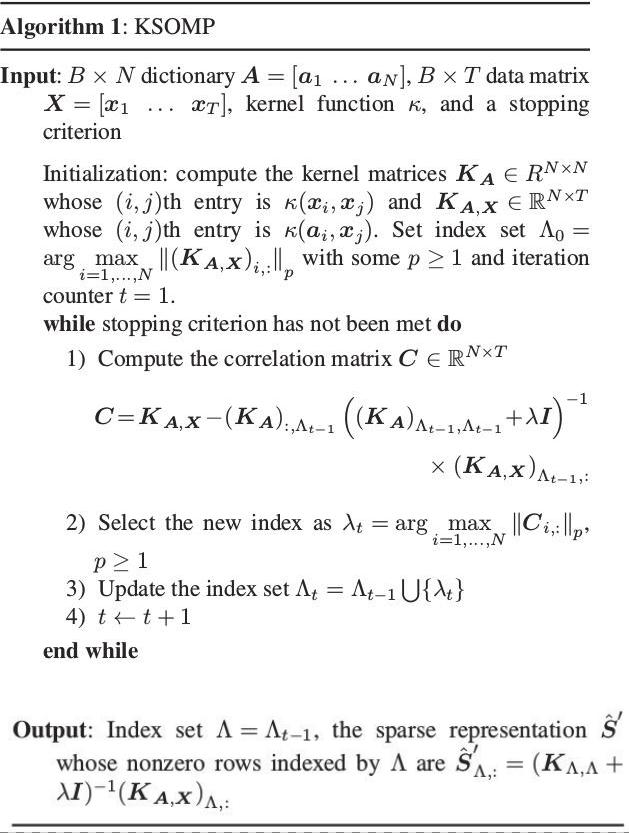
实现时写代码的核心就是这里的优化算法(OMP),确实是极大简化了计算,分明是个优化问题却连导数都不用求。。。算法的具体证明可以参考论文,这里给出文章里给的算法流程图:
实验结果
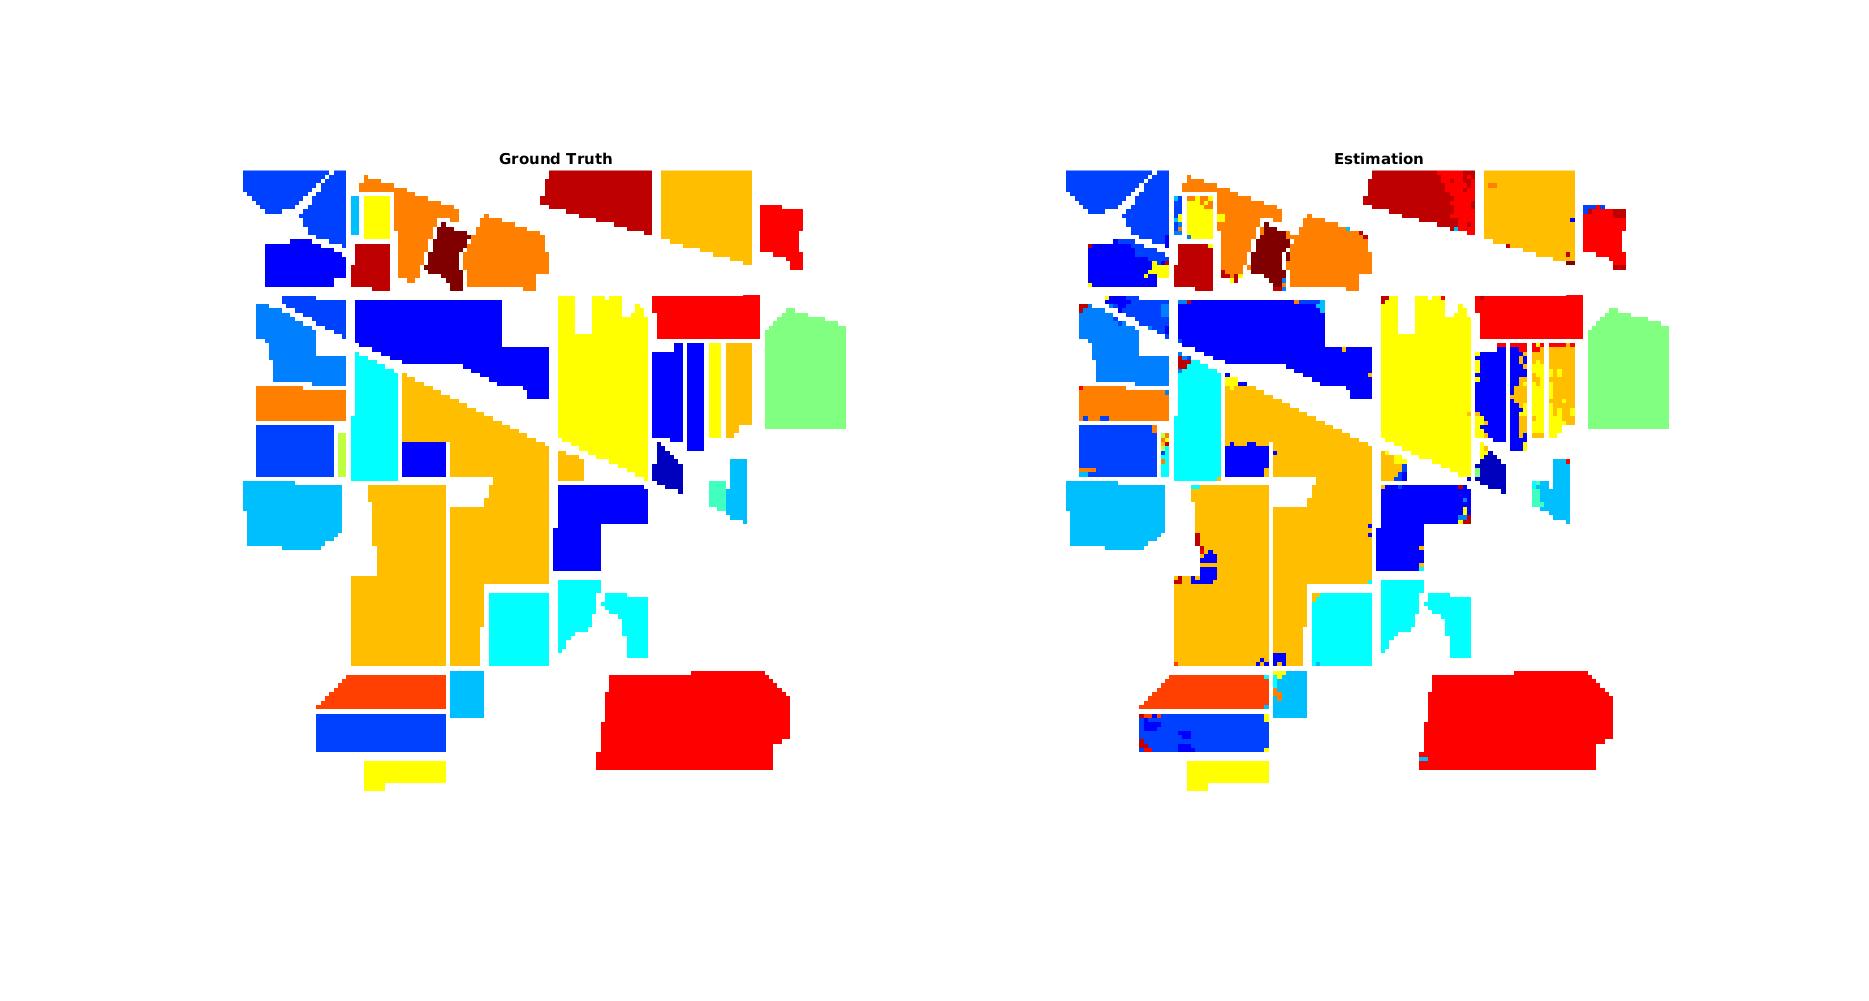
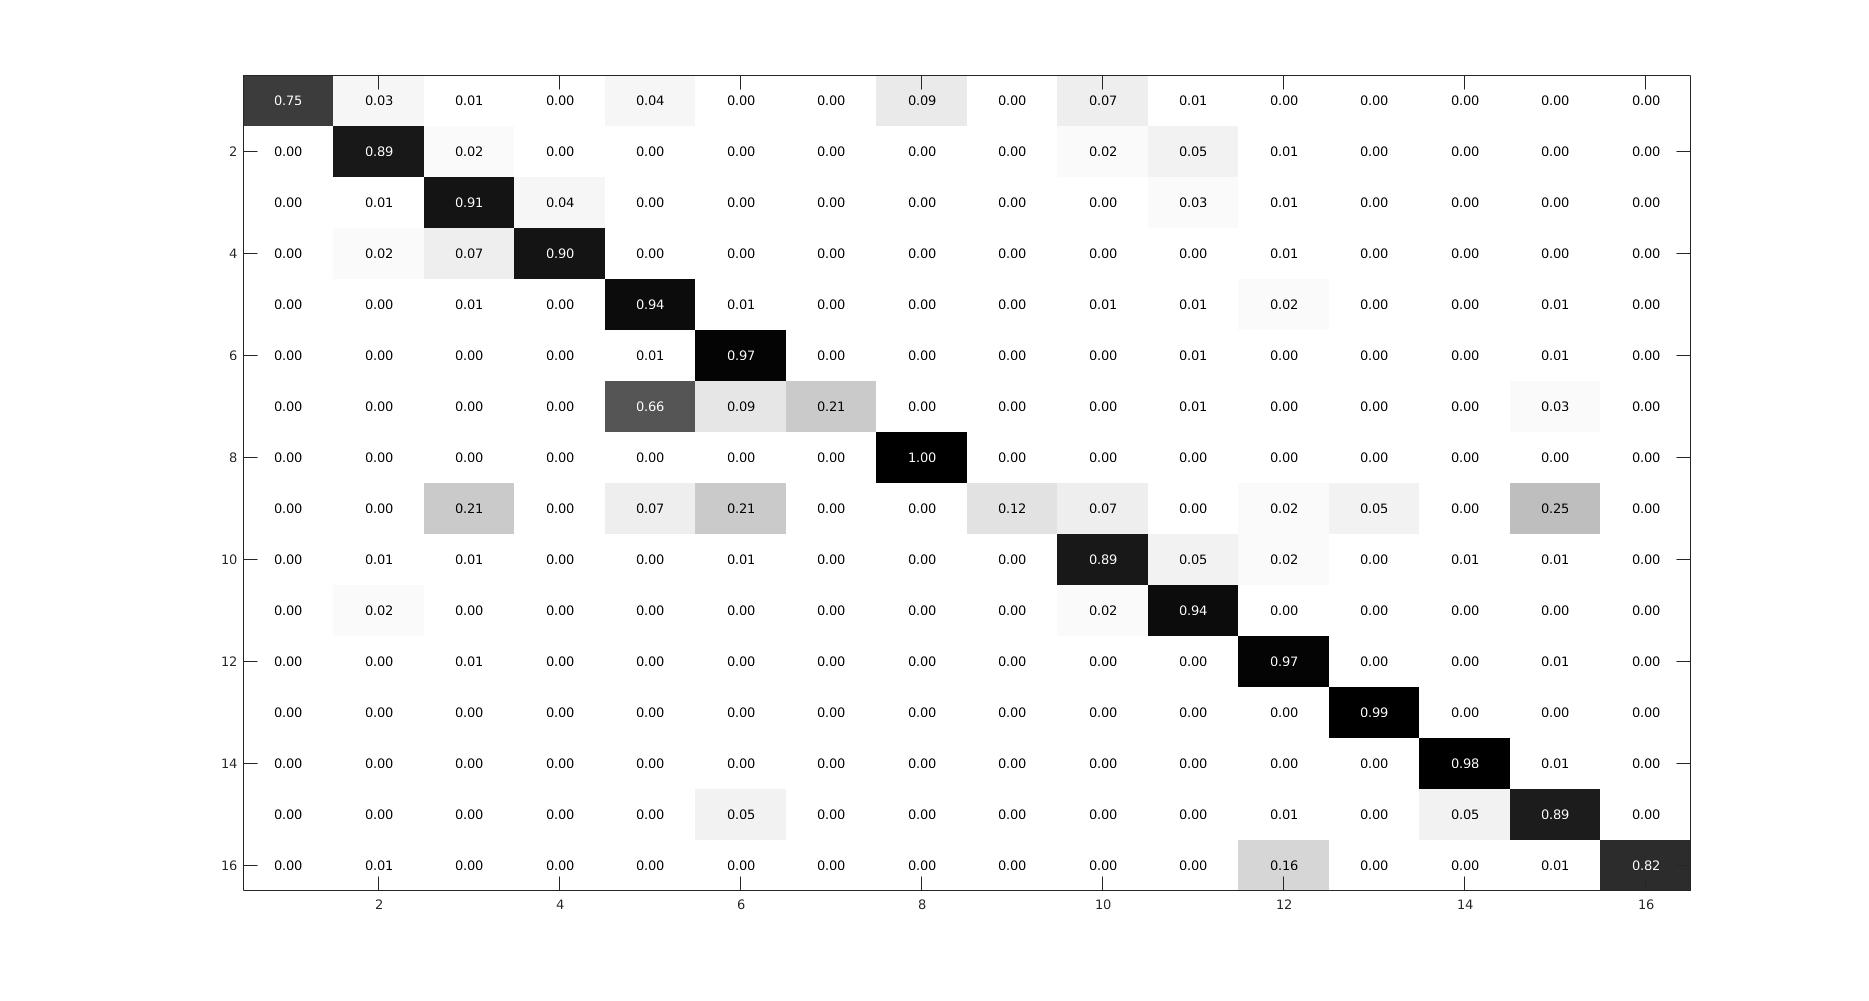
实验中随机选10%的数据训练,总共进行了10次训练并将每一次的混淆矩阵求平均,结果如下:
实验中遇到的问题主要是计算上的数值问题,因为有 RBF 核中的指数函数会将正常数值映射到非常接近0,产生误差,因此把原数据正规化0,1之间很重要。还有一些其他的计算细节需要注意。总之算法看起来简单明了,但自己动手实现时还是有很多要注意的地方。
实验中使用的代码可以在这里看到:代码
Reference:
1.Hyperspectral image classification via kernel sparse representation . Y Chen, NM Nasrabadi, TD TranGeoscience and Remote Sensing, IEEE Transactions on 51 (1), 217-231
2.Hyperspectral image classification using dictionary-based sparse representation . Y Chen, NM Nasrabadi, TD TranGeoscience and Remote Sensing, IEEE Transactions on 49 (10), 3973-3985
3.Sparse representation for target detection in hyperspectral imagery . Y Chen, NM Nasrabadi, TD TranSelected Topics in Signal Processing, IEEE Journal of 5 (3), 629-640