<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>Zhang Yu&#39;s notes</title>
  
  <link href="/atom.xml" rel="self"/>
  
  <link href="https://zhangyuygss.github.io/"/>
  <updated>2017-05-05T09:54:11.992Z</updated>
  <id>https://zhangyuygss.github.io/</id>
  
  <author>
    <name>Yu Zhang</name>
    
  </author>
  
  <generator uri="http://hexo.io/">Hexo</generator>
  
  <entry>
    <title>HSI_Classification</title>
    <link href="https://zhangyuygss.github.io/2017/05/05/HSI-Classification/"/>
    <id>https://zhangyuygss.github.io/2017/05/05/HSI-Classification/</id>
    <published>2017-05-05T07:40:18.000Z</published>
    <updated>2017-05-05T09:54:11.992Z</updated>
    
    <content type="html"><![CDATA[<h3 id="高光谱图像分类实验"><a href="#高光谱图像分类实验" class="headerlink" title="高光谱图像分类实验"></a>高光谱图像分类实验</h3><p>参考论文 *[Hyperspectral Image Classification via kernel sparse representstion][1]，实现基于核方法（kernel）和稀疏表示（sparse representation）的高光谱图像分类算法。本文大致介绍论文中的方法和代码实现。文章是5、6年前提出的了，个人不是很了解最近这个方面最新的发展，似乎也有基于深度网络的分类算法出现。但从被引情况看这篇文章应该比较经典，而且从练手的角度看，实现核与稀疏表示这些经典方法相较于再套用一下神经网络也更有意义，因此实现其方法并简单介绍。</p>
<a id="more"></a>
<h4 id="方法介绍"><a href="#方法介绍" class="headerlink" title="方法介绍"></a>方法介绍</h4><h5 id="高光谱图像"><a href="#高光谱图像" class="headerlink" title="高光谱图像"></a>高光谱图像</h5><p>高光谱图像（Hyperspectral image）相较于传统的 RGB 图像有更多波段的信息。RGB图像有红绿蓝三个波段的信息，于是它的数字图像可用 <em>row x column x 3</em> 的 tensor 表示；而高光谱图像可能包含几百个波段上的信息，比如某高光谱图像包含200个波段信息，那么它的大小为 <em>row x column x 200</em> 。高光谱图像的这些波段包含了许多RGB图像中没有的信息，因此它可以用于图像中的物体分类和目标检测等很多任务。本文就介绍一种基于核与稀疏表示的高光谱图像内区域分类算法。</p>
<h5 id="高光谱图像的分类"><a href="#高光谱图像的分类" class="headerlink" title="高光谱图像的分类"></a>高光谱图像的分类</h5><p>假设有一个高光谱图像，它的波段数为$B=200$。那么图像中一个点可以用一个200维的向量$x\in R^{B}$表示，整张图像包含 <em>row x column</em> 个这样的列向量。有监督分类任务中有部分点的类别信息已知，要设计算法使用这些已知类别的点来预测未知类别点的类别。实验中使用印第安农场的高光谱图像，它包含了所有需要预测的点的各个波段的信息和类别（Ground Truth），我们从中挑选出10%的点作为训练点，另外90%的点用于test评估算法性能。</p>
<h5 id="高光谱图像的稀疏表示"><a href="#高光谱图像的稀疏表示" class="headerlink" title="高光谱图像的稀疏表示"></a>高光谱图像的稀疏表示</h5><p>假设我们现在有 <em>N</em> 个训练数据点，用矩阵 <em>A</em> 表示这些点的集合: $A = [a_1,a_2,\cdots ,a_N] \in R^{B\times N} , a_i \in R^B$ ,其中 $a_i$ 表示第 <em>i</em> 个训练点。那么图像中任意一个点可以用这些训练点的线性组合表示:<br>$$<br>\begin{align}<br>x &amp; \approx \alpha_1a_1+ \alpha_2a_2 + \cdots + \alpha_Na_N \\<br>&amp; = A\alpha<br>\end{align}<br>$$<br>其中 $\alpha \in R^N$ 为稀疏表示的系数向量，之所以叫稀疏表示，是因为系数向量$\alpha$这个N维向量中绝大部分元素都是0。也就是说，只要用少量训练数据点的线性组合就能很好地还原任意点的信息。截图直观地了解这种表示: <img src="https://zhangyuygss.github.io/uploads/sparseDemo.png" alt="sparse"></p>
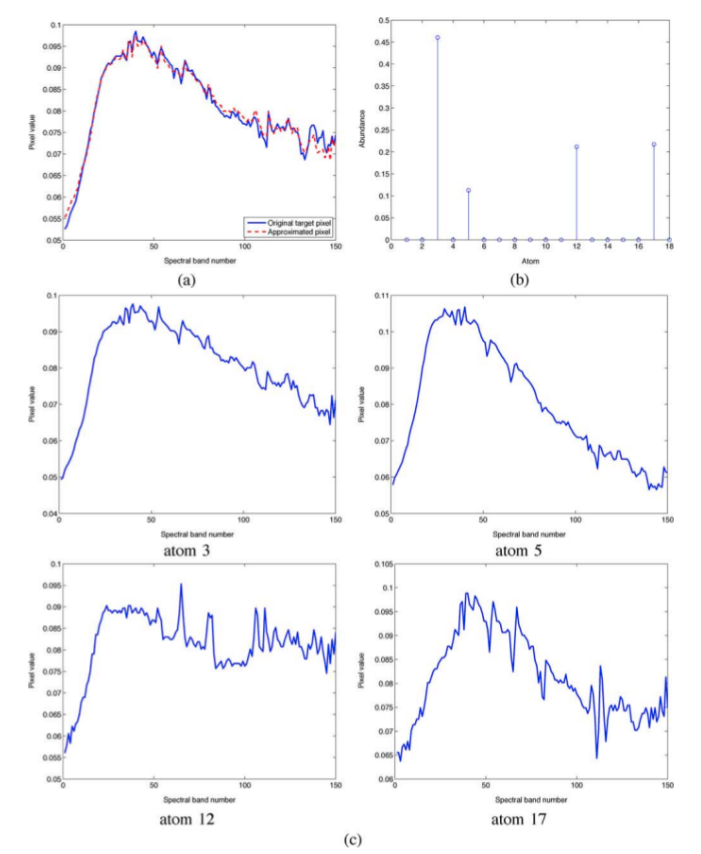
<p>图中左上红色表示稀疏表示的近似，下面四个是用于近似测试点的训练点，可见只用了四个训练点就很好地还原了一个测试点的光谱信息。</p>
<p>我们需要寻找合适的方法来找到每一个测试点的近似信息，使得使用较少的训练点的线性组合来较好地还原测试点，对于任意一个测试点 $x$ 可以用如下式子表示:<br>$$<br>\alpha = argmin||x-A\alpha||_2 \\<br>s.t.||\alpha||_0 \le K_0<br>$$<br>其中 $||\alpha||_0$ 表示系数向量 $\alpha$ 中非零元的个数，也叫 <em>sparse level</em>。也就是说：使用训练点中少于 $K_0$ 个点的线性组合来尽可能准确地还原测试点。这个最优化问题的解法就是本文开头文章的核心算法。文章中给出了两种基于贪心算法的优化方法： <em>OMP</em> 和 <em>SP</em> ，这里仅实现第一种算法的代码。</p>
<p>对于某个测试点，有了上面提到的稀疏表示，我们就可以直接预测该点的类别了。既然测试点可以用一些训练点的组合来表示，那么很自然地认为稀疏表示中用到的某一类的测试点个数越多就代表它和该类越接近，也就属于该类。更精确一点：仅用 $\alpha$ 中某一类的值来表示测试点，那么如果该表示相比于仅用其他类表示时和测试点的差距最小，那么可以认为测试点属于该类：<br>$$<br>Class(x) = argmin_{m=1,\cdots ,M}Res \\<br>Res =  ||x-A_{:,\Omega_m}\bar \alpha_{\Omega_m}||_2<br>$$<br>其中 <em>M</em> 为总类别数，$\bar \alpha$ 表示 $\alpha$ 中的非零部分， $\Omega_m$  表示用于稀疏表示的线性组合中实际使用到的训练点中属于第 <em>m</em> 类的下标。</p>
<p>方法的基本结构就是上面提到的那样了，其实这种方法类似 <em>KNN</em> ，使用稀疏表示构造出了某种测试点到各个类的距离，然后直接按照这种距离判断类别。</p>
<h5 id="核方法"><a href="#核方法" class="headerlink" title="核方法"></a>核方法</h5><p>核方法用于通过函数 $\Phi(x)$ 将低维特征映射到高维，从而将线性不可分的问题转换称线性可分问题。这里引入该方法应该是为了提高分类性能。 $\Phi(x)$ 通常较难计算，但在计算中通常会归结成需要计算函数 $\Phi(x)$ 之间的内积，而这种内积通常可以用核函数表示: $k(x_i,x_j)=&lt;\Phi(x_i),\Phi(x_j)&gt;$ 。也就是说不用先计算映射函数 $\Phi(x)$ 再算内积$&lt;\Phi(x_i),\Phi(x_j)&gt;$, 而是可以直接使用原特征 $x$ 计算核函数，就能得到上面要计算的内积。实验中用到 <em>RBF</em> 核: $k(x_i,x_j)=exp(-\gamma||x_i-x_j||^2)$ 。</p>
<p>z实验中通过核函数将数据点 $x$ 映射到高维，计算中原来向量 $x$ 之间的内积需要使用核函数来代替，具体的细节可以参考论文和代码，这里不再赘述。</p>
<h5 id="近邻信息"><a href="#近邻信息" class="headerlink" title="近邻信息"></a>近邻信息</h5><p>考虑到该分类任务中同一类别的点会集中在一起，即相邻的点很有可能属于同一类别。那么相邻的点在使用稀疏表示时就可以不各自使用不同的训练点表示，而是使用相同的一组基和不同的系数来表示：<br>$$<br>X=[x_1,x_2,\cdots ,x_T]=[A\alpha_1,A\alpha_2,\cdots, A\alpha_T] \\<br>=AS<br>$$<br>在分类某一点$x$的类别，寻找稀疏表示时，不是优化这一个点的稀疏表示，而是把以该点为中心周围的 <em>T</em> 个点的稀疏表示作为目标优化，从而考虑了邻近信息。实验中会发现这种方法会给分类效果带来很大提升。不过使用了近邻信息也会带来弊端：边缘分类效果变差、较小的区域分类不好。<br>$$<br>\bar S=argmin||X-AS||_F \\<br>s.t.||S||_{row,0}\le K_0<br>$$<br>判断类别的表达式变为:<br>$$<br>Class(x)=argmin_{m=1,\cdots ,M}||X-A_{:,\Omega_m}\bar S_{\Omega_m,:}||_F<br>$$<br>$||x||_F$ 表示 <em>Frobenius</em> 范式。</p>
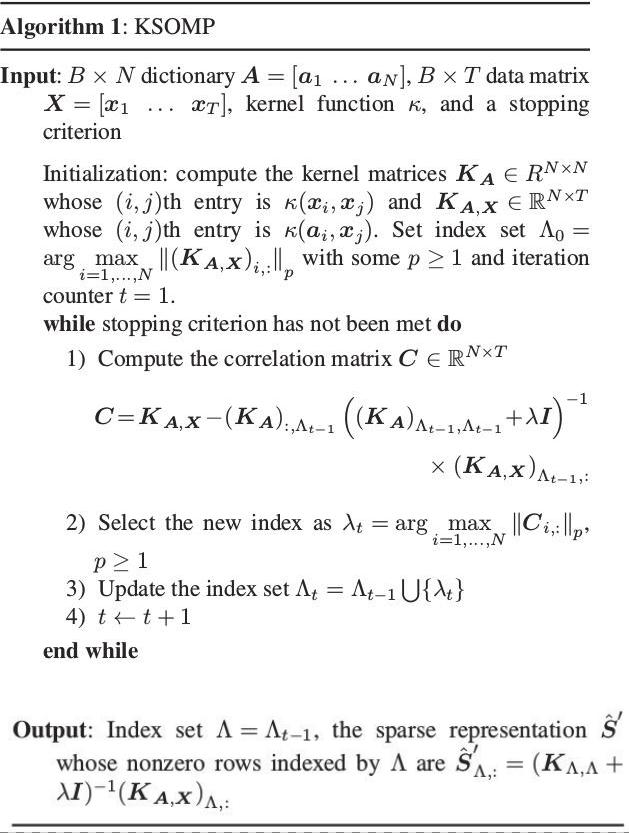
<h5 id="正交匹配追踪OMP"><a href="#正交匹配追踪OMP" class="headerlink" title="正交匹配追踪OMP"></a>正交匹配追踪OMP</h5><p>实现时写代码的核心就是这里的优化算法（OMP），确实是极大简化了计算，分明是个优化问题却连导数都不用求。。。算法的具体证明可以参考论文，这里给出文章里给的算法流程图：</p>
<p><img src="https://zhangyuygss.github.io/uploads/KSOMP.jpg" alt="KSOMP"></p>
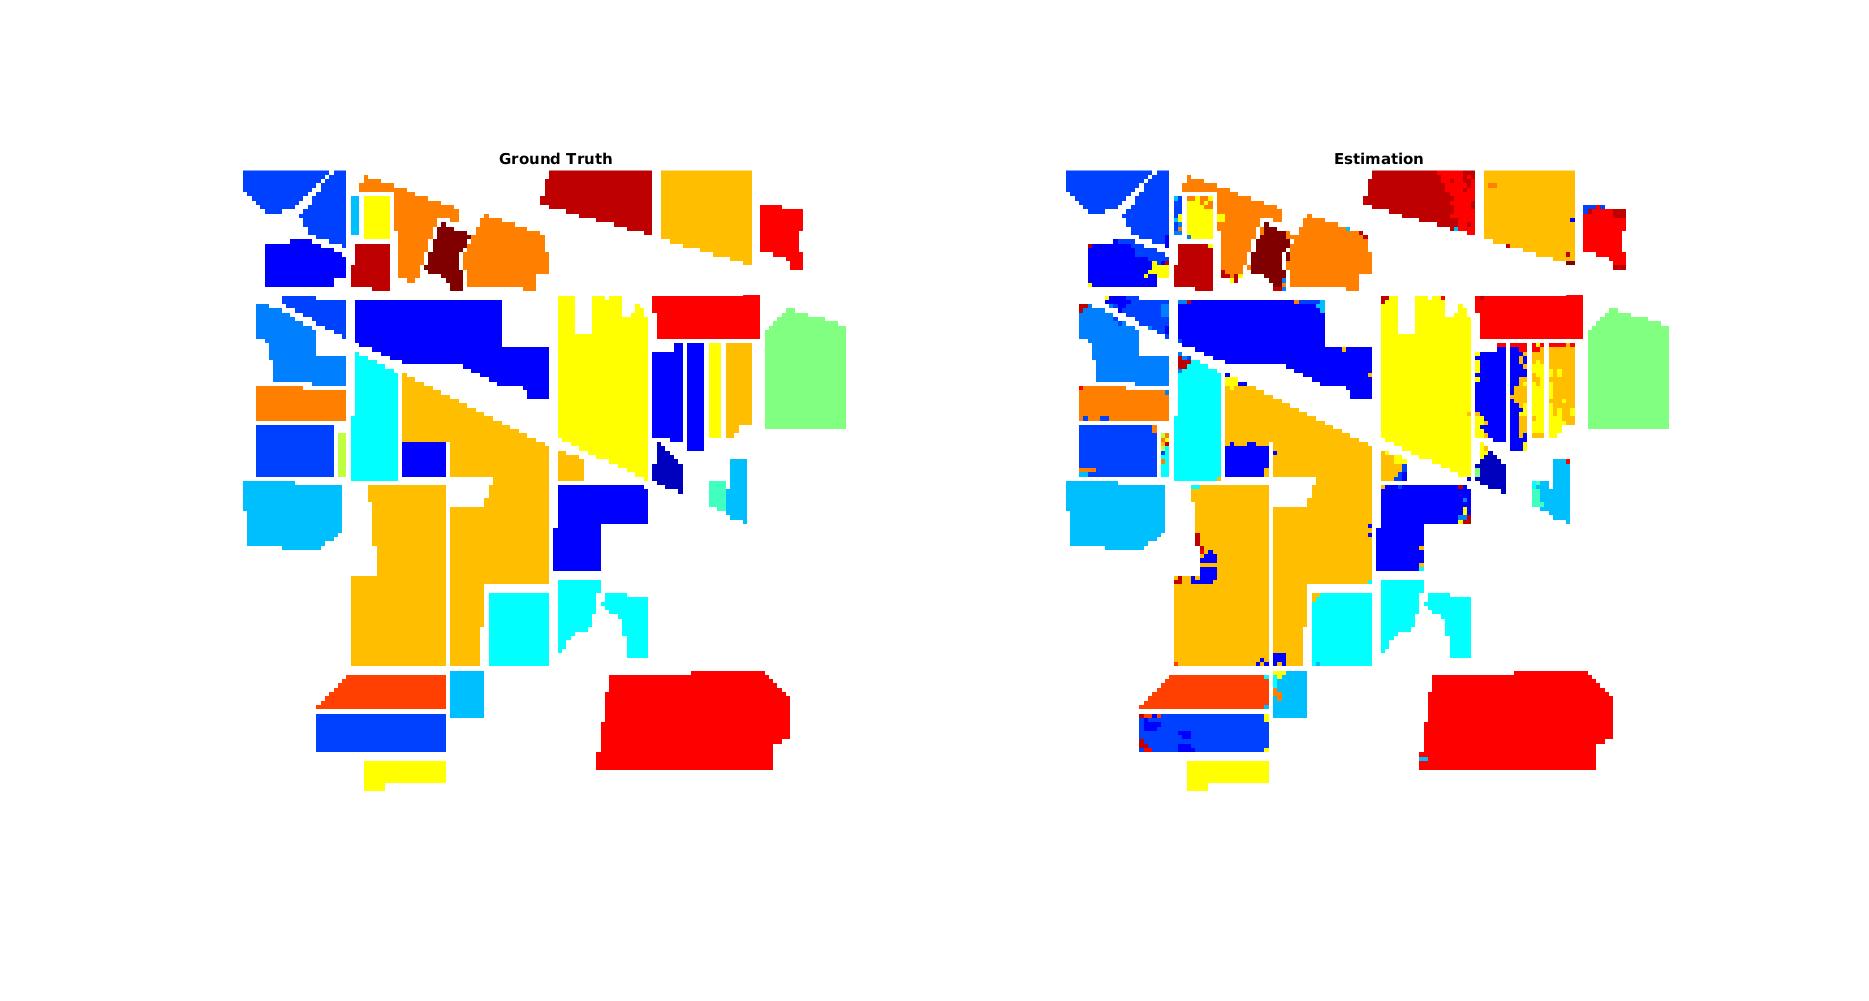
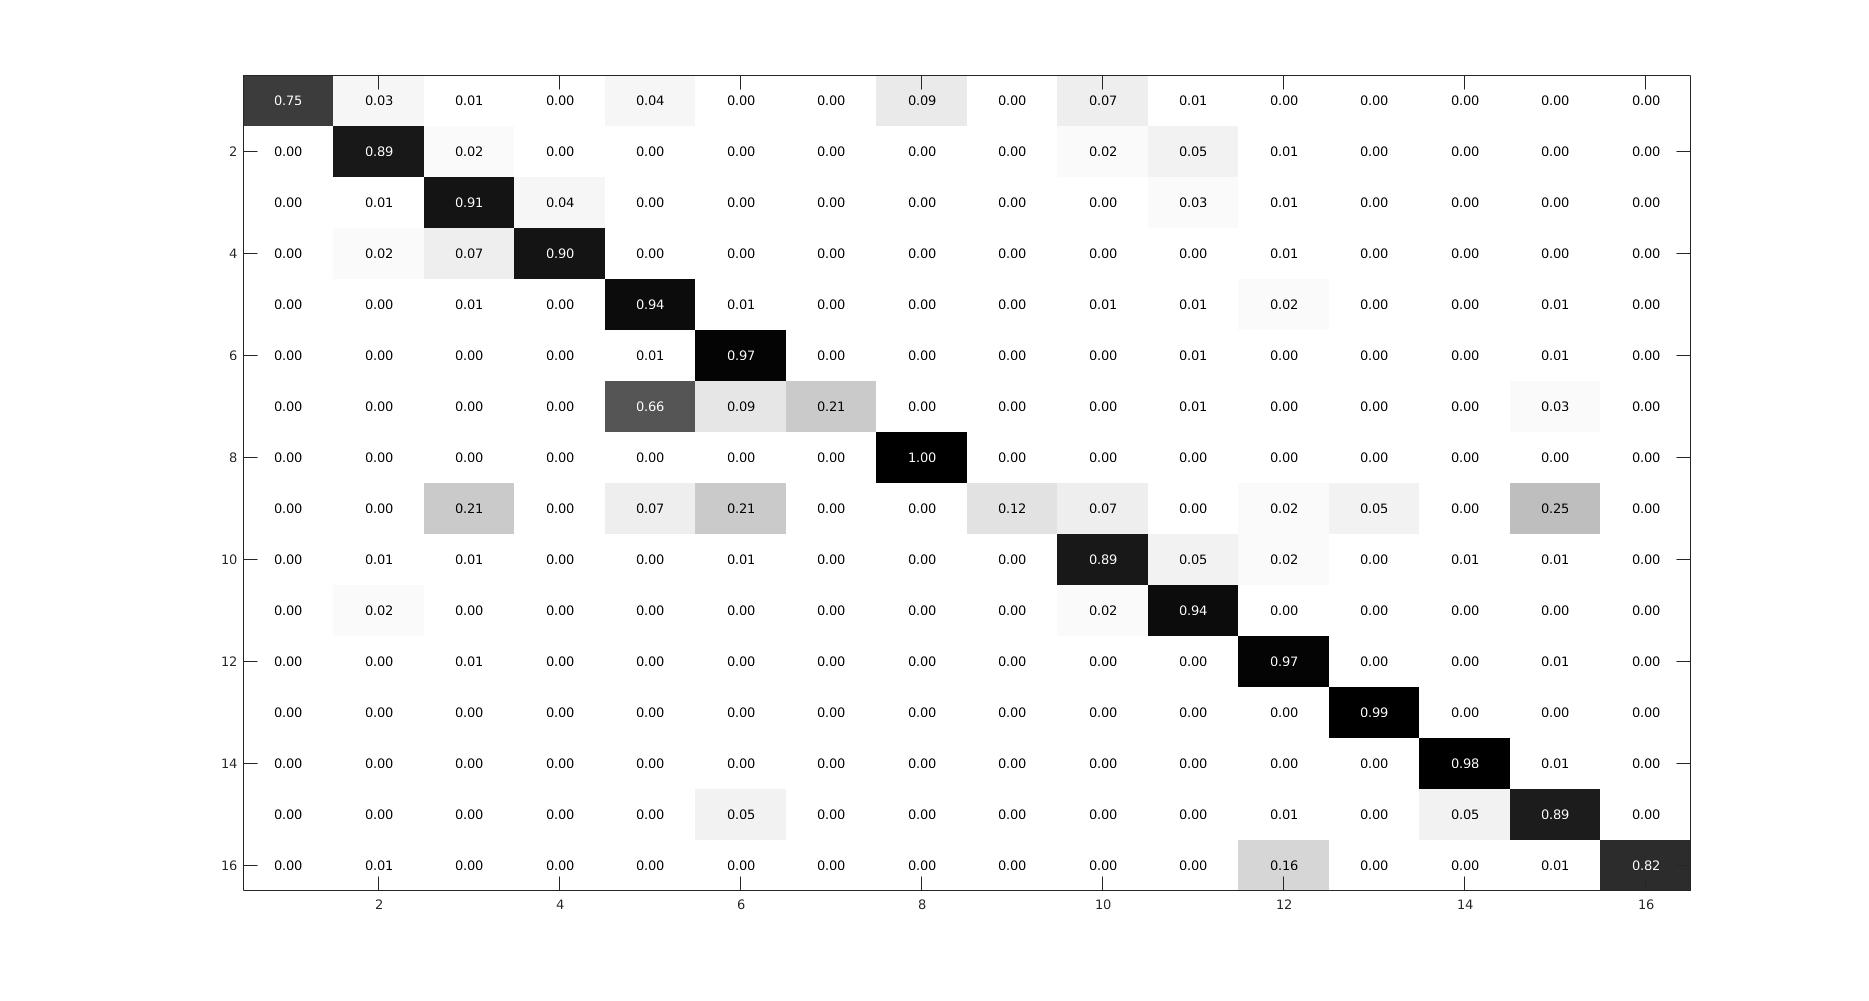
<h4 id="实验结果"><a href="#实验结果" class="headerlink" title="实验结果"></a>实验结果</h4><p>实验中随机选10%的数据训练，总共进行了10次训练并将每一次的混淆矩阵求平均，结果如下：</p>
<p><img src="https://zhangyuygss.github.io/uploads/rst.jpg" alt="KSOMP"></p>
<p><img src="https://zhangyuygss.github.io/uploads/error_matrix.jpg" alt="KSOMP"></p>
<p>实验中遇到的问题主要是计算上的数值问题，因为有 <em>RBF</em> 核中的指数函数会将正常数值映射到非常接近0，产生误差，因此把原数据正规化0,1之间很重要。还有一些其他的计算细节需要注意。总之算法看起来简单明了，但自己动手实现时还是有很多要注意的地方。</p>
<p>实验中使用的代码可以在这里看到：<a href="https://github.com/zhangyuygss/HSI_Classification" target="_blank" rel="external">代码</a></p>
<p>Reference:</p>
<p>1.<a href="https://scholar.google.com/citations?view_op=view_citation&amp;hl=en&amp;user=9rsuU6UAAAAJ&amp;citation_for_view=9rsuU6UAAAAJ:d1gkVwhDpl0C" target="_blank" rel="external">Hyperspectral image classification via kernel sparse representation</a> . Y Chen, NM Nasrabadi, TD TranGeoscience and Remote Sensing, IEEE Transactions on 51 (1), 217-231</p>
<p>2.<a href="https://scholar.google.com/citations?view_op=view_citation&amp;hl=en&amp;user=9rsuU6UAAAAJ&amp;citation_for_view=9rsuU6UAAAAJ:u-x6o8ySG0sC" target="_blank" rel="external">Hyperspectral image classification using dictionary-based sparse representation</a> . Y Chen, NM Nasrabadi, TD TranGeoscience and Remote Sensing, IEEE Transactions on 49 (10), 3973-3985</p>
<p>3.<a href="https://scholar.google.com/citations?view_op=view_citation&amp;hl=en&amp;user=9rsuU6UAAAAJ&amp;citation_for_view=9rsuU6UAAAAJ:9yKSN-GCB0IC" target="_blank" rel="external">Sparse representation for target detection in hyperspectral imagery</a> . Y Chen, NM Nasrabadi, TD TranSelected Topics in Signal Processing, IEEE Journal of 5 (3), 629-640</p>
]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;高光谱图像分类实验&quot;&gt;&lt;a href=&quot;#高光谱图像分类实验&quot; class=&quot;headerlink&quot; title=&quot;高光谱图像分类实验&quot;&gt;&lt;/a&gt;高光谱图像分类实验&lt;/h3&gt;&lt;p&gt;参考论文 *[Hyperspectral Image Classification via kernel sparse representstion][1]，实现基于核方法（kernel）和稀疏表示（sparse representation）的高光谱图像分类算法。本文大致介绍论文中的方法和代码实现。文章是5、6年前提出的了，个人不是很了解最近这个方面最新的发展，似乎也有基于深度网络的分类算法出现。但从被引情况看这篇文章应该比较经典，而且从练手的角度看，实现核与稀疏表示这些经典方法相较于再套用一下神经网络也更有意义，因此实现其方法并简单介绍。&lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>神经网络解常微分方程</title>
    <link href="https://zhangyuygss.github.io/2017/03/28/%E7%A5%9E%E7%BB%8F%E7%BD%91%E7%BB%9C%E8%A7%A3%E5%B8%B8%E5%BE%AE%E5%88%86%E6%96%B9%E7%A8%8B/"/>
    <id>https://zhangyuygss.github.io/2017/03/28/神经网络解常微分方程/</id>
    <published>2017-03-28T13:33:13.000Z</published>
    <updated>2017-03-28T16:28:38.744Z</updated>
    
    <content type="html"><![CDATA[<h4 id="神经网络解常微分方程"><a href="#神经网络解常微分方程" class="headerlink" title="神经网络解常微分方程"></a>神经网络解常微分方程</h4><p>对于常微分方程</p>
<p>$$<br>\left{<br>\begin{array}{c}<br>\frac{dy}{dx}=x^3-\frac{y}{x}\\<br>y(1)=\frac{2}{5}<br>\end{array}<br>\right.<br>$$<br>其精确解为 $y(x)=\frac{x^4}{5}+\frac{1}{5x}$ .</p>
<p>下面用3层 <em>1xNx1</em> 神经网络解该问题。</p>
<a id="more"></a>
<p>设 $f(x)=y_t=\frac{dy}{dx} = y_0+xN(x,p)$ , 其中 $N(x,p)$ 是三层神经网络的输出， $p$ 是网络中的参数，维度为 $3n$ 。在区间 $[1,2]$ 中取 m 个点做训练数据。求解最优化问题<br>$$<br>min\sum_{i=1}^m{ \frac{dy_t(x,p)}{dx}|_{x=x_i}-f(x_i,y_t(x_i,p)) }^2<br>$$<br>将得到的 $p$ 带入到 $y_t(x,p)$ 中就能得出训练出来的该微分方程的近似解。</p>
<p>通过计算可以得出上式平方内的项为:<br>$$<br>J(x_i) = \sum_{j=1}^n\frac{2v_j}{1+e^{\theta_j-\omega_jx_i}}+\sum_{j=1}^n\frac{xv_j\omega_je^{\theta_j-\omega_jx_i}}{(1+e^{\theta_j-\omega_jx_i})^2}-x_i^3+\frac{0.4}{x_i}<br>$$<br>给出表示上述函数及其导数的代码:</p>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div><div class="line">21</div><div class="line">22</div><div class="line">23</div><div class="line">24</div><div class="line">25</div></pre></td><td class="code"><pre><div class="line"><span class="function"><span class="keyword">function</span> <span class="title">f</span> = <span class="title">fnde</span><span class="params">(p)</span></span></div><div class="line">	<span class="comment">%% Loss function of neural network method to solve differential equation</span></div><div class="line">	<span class="comment">% a 1-n-1 3 layer neural network</span></div><div class="line">	<span class="comment">% p is 3n dimensional parameter column vector</span></div><div class="line">	m = <span class="number">10</span>;					<span class="comment">% points selected in interval [1,2]</span></div><div class="line">	xs = [<span class="number">1</span>:<span class="number">1</span>/(m<span class="number">-1</span>):<span class="number">2</span>]';</div><div class="line">	f = <span class="number">0</span>;</div><div class="line">	<span class="keyword">for</span> iter = <span class="number">1</span>:<span class="built_in">length</span>(xs)</div><div class="line">		ftmp = finner(xs(iter), p);</div><div class="line">		f = f + ftmp^<span class="number">2</span>;</div><div class="line">	<span class="keyword">end</span></div><div class="line"><span class="keyword">end</span></div><div class="line"></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="title">fx</span> = <span class="title">finner</span><span class="params">(x, p)</span></span></div><div class="line">	<span class="comment">% x 1 dimensional number</span></div><div class="line">	<span class="comment">% p is 3n dimensional parameter column vector</span></div><div class="line">	<span class="comment">% f is 1 dim number</span></div><div class="line">	n = <span class="built_in">length</span>(p)/<span class="number">3</span>;</div><div class="line">	v = p(<span class="number">1</span>:n);</div><div class="line">	theta = p(n+<span class="number">1</span>: <span class="number">2</span>*n);</div><div class="line">	omega = p(<span class="number">2</span>*n+<span class="number">1</span> : <span class="keyword">end</span>);</div><div class="line"></div><div class="line">	z = x*omega - theta;</div><div class="line">	fx = <span class="number">2</span>*v'*sigmoid(z) + x*(v.*omega)'*(<span class="built_in">exp</span>(-z).*(sigmoid(z).^<span class="number">2</span>)) - x^<span class="number">3</span> + <span class="number">2</span>/<span class="number">5</span>/x;</div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div><div class="line">21</div><div class="line">22</div><div class="line">23</div><div class="line">24</div><div class="line">25</div><div class="line">26</div><div class="line">27</div><div class="line">28</div><div class="line">29</div><div class="line">30</div><div class="line">31</div><div class="line">32</div><div class="line">33</div><div class="line">34</div><div class="line">35</div><div class="line">36</div><div class="line">37</div><div class="line">38</div><div class="line">39</div><div class="line">40</div><div class="line">41</div><div class="line">42</div></pre></td><td class="code"><pre><div class="line"><span class="comment">%% gnde: Gradient of loss function of neural network method to solve differential equation</span></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="title">grad</span> = <span class="title">gnde</span><span class="params">(p)</span></span></div><div class="line">	m = <span class="number">10</span>;					<span class="comment">% points selected in interval [1,2]</span></div><div class="line">	xs = [<span class="number">1</span>:<span class="number">1</span>/(m<span class="number">-1</span>):<span class="number">2</span>]';</div><div class="line">	grad = <span class="built_in">zeros</span>(<span class="built_in">length</span>(p), <span class="number">1</span>);</div><div class="line">	<span class="keyword">for</span> iter = <span class="number">1</span>:<span class="built_in">length</span>(xs)</div><div class="line">		gradtmp = ginner(xs(iter), p);</div><div class="line">		grad = grad + gradtmp;</div><div class="line">	<span class="keyword">end</span></div><div class="line"><span class="keyword">end</span></div><div class="line"></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[gx]</span> = <span class="title">ginner</span><span class="params">(x, p)</span></span></div><div class="line">	n = <span class="built_in">length</span>(p)/<span class="number">3</span>;</div><div class="line">	v = p(<span class="number">1</span>:n);</div><div class="line">	theta = p(n+<span class="number">1</span>: <span class="number">2</span>*n);</div><div class="line">	omega = p(<span class="number">2</span>*n+<span class="number">1</span> : <span class="keyword">end</span>);	</div><div class="line"></div><div class="line">	fx = finner(x, p);				<span class="comment">% 1 dim	</span></div><div class="line"></div><div class="line">	z       = x*omega - theta;</div><div class="line">	d_v     = <span class="number">2</span>*sigmoid(z) + x*omega.*<span class="built_in">exp</span>(-z).*(sigmoid(z).^<span class="number">2</span>);</div><div class="line">	d_theta = (x*v.*omega - <span class="number">2</span>*v).*<span class="built_in">exp</span>(-z).*(sigmoid(z).^<span class="number">2</span>) - ...</div><div class="line">			  <span class="number">2</span>*x*v.*omega.*<span class="built_in">exp</span>(<span class="number">-2</span>*z).*(sigmoid(z).^<span class="number">3</span>);</div><div class="line">	d_omega = (<span class="number">3</span>*x*v - x^<span class="number">2</span>*v.*omega).*<span class="built_in">exp</span>(-z).*(sigmoid(z).^<span class="number">2</span>) + ...</div><div class="line">			  <span class="number">2</span>*x^<span class="number">2</span>*v.*omega.*<span class="built_in">exp</span>(<span class="number">-2</span>*z).*(sigmoid(z).^<span class="number">3</span>);</div><div class="line"></div><div class="line">	gx = [d_v; d_theta; d_omega];</div><div class="line">	gx = <span class="number">2</span>*fx*gx;</div><div class="line"><span class="keyword">end</span></div><div class="line"></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="title">fx</span> = <span class="title">finner</span><span class="params">(x, p)</span></span></div><div class="line">	<span class="comment">% x 1 dimensional number</span></div><div class="line">	<span class="comment">% p is 3n dimensional parameter column vector</span></div><div class="line">	<span class="comment">% f is 1 dim number</span></div><div class="line">	n = <span class="built_in">length</span>(p)/<span class="number">3</span>;</div><div class="line">	v = p(<span class="number">1</span>:n);</div><div class="line">	theta = p(n+<span class="number">1</span>: <span class="number">2</span>*n);</div><div class="line">	omega = p(<span class="number">2</span>*n+<span class="number">1</span> : <span class="keyword">end</span>);</div><div class="line"></div><div class="line">	z = x*omega - theta;</div><div class="line">	fx = <span class="number">2</span>*v'*sigmoid(z) + x*(v.*omega)'*(<span class="built_in">exp</span>(-z).*(sigmoid(z).^<span class="number">2</span>)) - x^<span class="number">3</span> + <span class="number">2</span>/<span class="number">5</span>/x;</div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<p>利用拟牛方法计算参数 $p$ 的值并画图和真实解析解进行比较:</p>
<p><img src="../uploads/fnde.jpg" alt="fnde"></p>
]]></content>
    
    <summary type="html">
    
      &lt;h4 id=&quot;神经网络解常微分方程&quot;&gt;&lt;a href=&quot;#神经网络解常微分方程&quot; class=&quot;headerlink&quot; title=&quot;神经网络解常微分方程&quot;&gt;&lt;/a&gt;神经网络解常微分方程&lt;/h4&gt;&lt;p&gt;对于常微分方程&lt;/p&gt;
&lt;p&gt;$$&lt;br&gt;\left{&lt;br&gt;\begin{array}{c}&lt;br&gt;\frac{dy}{dx}=x^3-\frac{y}{x}\\&lt;br&gt;y(1)=\frac{2}{5}&lt;br&gt;\end{array}&lt;br&gt;\right.&lt;br&gt;$$&lt;br&gt;其精确解为 $y(x)=\frac{x^4}{5}+\frac{1}{5x}$ .&lt;/p&gt;
&lt;p&gt;下面用3层 &lt;em&gt;1xNx1&lt;/em&gt; 神经网络解该问题。&lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>拟牛顿方法测试</title>
    <link href="https://zhangyuygss.github.io/2017/03/28/%E6%8B%9F%E7%89%9B%E9%A1%BF%E6%96%B9%E6%B3%95%E6%B5%8B%E8%AF%95/"/>
    <id>https://zhangyuygss.github.io/2017/03/28/拟牛顿方法测试/</id>
    <published>2017-03-28T11:24:13.000Z</published>
    <updated>2017-03-28T13:47:37.482Z</updated>
    
    <content type="html"><![CDATA[<h4 id="测试函数"><a href="#测试函数" class="headerlink" title="测试函数"></a>测试函数</h4><h5 id="Watson-函数"><a href="#Watson-函数" class="headerlink" title="Watson 函数"></a>Watson 函数</h5><p>$$<br>min \sum_{i=1}^{m}r_i^2(x) \\<br>r_i(x) = \sum_{j=2}^n(j-1)x_jt_i^{j-2} - (\sum_{j=1}^nx_jt_i^{j-1})^2 - 1<br>$$</p>
<p>其中，$t_i=i/29,~ 1 \le i \le 29,~ r_{30}=x_1,~ r_{31} = x_2 - x_1^2 -1,~ 2 \le n \le 31,~ m = 31$ . 初始点选为 $x^{(0)} = (0, \dots ,)^T$. </p>
<a id="more"></a>
<p>根据文章[1],   $watson$ 函数的最小值为:<br>$$<br>f=2.28767 \cdots 10^{-3} <del>~~if~n=6\\<br>f=1.39976 \cdots 10^{-6} ~</del>~if~n=9\\<br>f=4.72238 \cdots 10^{-10} ~~~~if~n=12<br>$$</p>
<p>函数形式比较复杂，求一阶导的过程比较繁琐，写出来也麻烦，直接给出 $watson$ 函数和它的导数的matlab 代码:</p>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div></pre></td><td class="code"><pre><div class="line"><span class="comment">%% Watson function, fix m = 31, n can be modified</span></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="title">w</span> = <span class="title">fwatson</span><span class="params">(x)</span></span></div><div class="line"><span class="comment">% x is n dim vector, w is 1 dim value</span></div><div class="line">	m = <span class="number">31</span>;  n = <span class="built_in">length</span>(x);</div><div class="line">	w = <span class="number">0</span>;</div><div class="line">	<span class="keyword">for</span> ii = <span class="number">1</span>:<span class="number">29</span></div><div class="line">		tmp_i1 = <span class="number">0</span>;</div><div class="line">		tmp_i2 = <span class="number">0</span>;</div><div class="line">		ti = ii/<span class="number">29</span>;</div><div class="line">		<span class="keyword">for</span> jj = <span class="number">1</span>:n</div><div class="line">			tmp_j1 = (jj<span class="number">-1</span>)*x(jj)*ti^(jj<span class="number">-2</span>);</div><div class="line">			tmp_j2 = x(jj)*ti^(jj<span class="number">-1</span>);</div><div class="line">			tmp_i1 = tmp_i1 + tmp_j1;</div><div class="line">			tmp_i2 = tmp_i2 + tmp_j2;</div><div class="line">		<span class="keyword">end</span></div><div class="line">		w = w + (tmp_i1 - tmp_i2^<span class="number">2</span> - <span class="number">1</span>)^<span class="number">2</span>;</div><div class="line">	<span class="keyword">end</span></div><div class="line">	<span class="comment">% add r30 and r31</span></div><div class="line">	w = w + x(<span class="number">1</span>)^<span class="number">2</span> + (x(<span class="number">2</span>) - x(<span class="number">1</span>)^<span class="number">2</span> <span class="number">-1</span>)^<span class="number">2</span>;</div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div><div class="line">21</div><div class="line">22</div><div class="line">23</div><div class="line">24</div><div class="line">25</div><div class="line">26</div><div class="line">27</div><div class="line">28</div><div class="line">29</div><div class="line">30</div><div class="line">31</div><div class="line">32</div><div class="line">33</div><div class="line">34</div><div class="line">35</div><div class="line">36</div><div class="line">37</div><div class="line">38</div><div class="line">39</div><div class="line">40</div><div class="line">41</div><div class="line">42</div><div class="line">43</div><div class="line">44</div><div class="line">45</div></pre></td><td class="code"><pre><div class="line"><span class="comment">%% gwatson: gradient of watson function</span></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[grad]</span> = <span class="title">gwatson</span><span class="params">(x)</span></span></div><div class="line"><span class="comment">% x is n dim vector, grad is n dim value</span></div><div class="line">	n = <span class="built_in">length</span>(x);</div><div class="line">	grad = <span class="built_in">zeros</span>(n, <span class="number">1</span>);</div><div class="line"></div><div class="line">	<span class="comment">% compute sum in the square</span></div><div class="line">	insum = <span class="built_in">zeros</span>(<span class="number">29</span>, <span class="number">1</span>);</div><div class="line">	<span class="keyword">for</span> ii = <span class="number">1</span>:<span class="number">29</span></div><div class="line">		ti = ii/<span class="number">29</span>;</div><div class="line">		<span class="keyword">for</span> jj = <span class="number">1</span>:n</div><div class="line">			insum(ii) = insum(ii) + x(jj)*ti^(jj<span class="number">-1</span>);</div><div class="line">		<span class="keyword">end</span></div><div class="line">	<span class="keyword">end</span></div><div class="line"></div><div class="line">	<span class="comment">% Compute r_i</span></div><div class="line">	r = <span class="built_in">zeros</span>(<span class="number">31</span>, <span class="number">1</span>);</div><div class="line">	<span class="keyword">for</span> ii = <span class="number">1</span>:<span class="number">29</span></div><div class="line">		r(ii) = r_i(ii, x, n);</div><div class="line">	<span class="keyword">end</span></div><div class="line">	r(<span class="number">30</span>) = x(<span class="number">1</span>);  r(<span class="number">31</span>) = x(<span class="number">2</span>) - x(<span class="number">1</span>)^<span class="number">2</span> - <span class="number">1</span>;</div><div class="line"></div><div class="line">	<span class="keyword">for</span> jj = <span class="number">1</span>:n</div><div class="line">		dfdxj = <span class="number">0</span>;</div><div class="line">		<span class="keyword">for</span> ii = <span class="number">1</span>:<span class="number">29</span></div><div class="line">			ti = ii/<span class="number">29</span>;</div><div class="line">			dridxj = ((jj<span class="number">-1</span>)*ti^(jj<span class="number">-2</span>) - <span class="number">2</span>*insum(ii)*ti^(jj<span class="number">-1</span>))*<span class="number">2</span>*r(ii);</div><div class="line">			dfdxj = dfdxj + dridxj;</div><div class="line">		<span class="keyword">end</span></div><div class="line">		grad(jj) = dfdxj + <span class="number">2</span>*r(<span class="number">30</span>);</div><div class="line">	<span class="keyword">end</span></div><div class="line">	grad(<span class="number">1</span>) = grad(<span class="number">1</span>) - <span class="number">2</span>*x(<span class="number">1</span>)*<span class="number">2</span>*r(<span class="number">31</span>);</div><div class="line">	grad(<span class="number">2</span>) = grad(<span class="number">2</span>) + <span class="number">2</span>*r(<span class="number">31</span>);</div><div class="line"><span class="keyword">end</span></div><div class="line"></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="title">ri</span> = <span class="title">r_i</span><span class="params">(i, x, n)</span></span></div><div class="line"><span class="comment">% compute r_i(x)</span></div><div class="line">	ti = <span class="built_in">i</span>/<span class="number">29</span>;</div><div class="line">	tmp_i1 = <span class="number">0</span>;  tmp_i2 = <span class="number">0</span>;</div><div class="line">	<span class="keyword">for</span> jj = <span class="number">1</span>:n</div><div class="line">		tmp_i1 = tmp_i1 + (jj<span class="number">-1</span>)*x(jj)*ti^(jj<span class="number">-2</span>);</div><div class="line">		tmp_i2 = tmp_i2 + x(jj)*ti^(jj<span class="number">-1</span>);</div><div class="line">	<span class="keyword">end</span></div><div class="line">	ri = tmp_i1 - tmp_i2^<span class="number">2</span> <span class="number">-1</span>;</div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<h5 id="Discrete-boundary-value-function"><a href="#Discrete-boundary-value-function" class="headerlink" title="Discrete boundary value function"></a>Discrete boundary value function</h5><p>$$<br>min \sum_{i=1}^n r_i^2(x) \\<br>r_i(x) = 2x_i - x_{i-1} - x_{i+1} + h^2(x_i + t_i + 1)^3/2<br>$$</p>
<p>其中 $h = 1/(n+1),~ t_i = ih,~ x_0 = x_{n+1} = 0,~ m=n$, 初始点选为 $x^{(0)} = (t_1(t_1-1), \cdots, t_n(t_n-1))^T$.</p>
<p>同样根据[1], 该函数的最小值为 $f = 0$.</p>
<p>函数和它的导数的代码:</p>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div></pre></td><td class="code"><pre><div class="line"><span class="comment">%% fdbv: Discrete boundary value</span></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[fx]</span> = <span class="title">fdbv</span><span class="params">(x)</span></span></div><div class="line">	m = <span class="built_in">length</span>(x);</div><div class="line">	fx = <span class="number">0</span>;</div><div class="line">	<span class="keyword">for</span> iter = <span class="number">1</span>:m</div><div class="line">		fx = fx + r_i(iter, x)^<span class="number">2</span>;</div><div class="line">	<span class="keyword">end</span></div><div class="line"><span class="keyword">end</span></div><div class="line"></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="title">ri</span> = <span class="title">r_i</span><span class="params">(ii, x)</span></span></div><div class="line">	n = <span class="built_in">length</span>(x);</div><div class="line">	x(n+<span class="number">1</span>) = <span class="number">0</span>;</div><div class="line">	h = <span class="number">1</span>/(n+<span class="number">1</span>);</div><div class="line">	ti = ii*h;</div><div class="line">	<span class="keyword">if</span>(ii == <span class="number">1</span>)		<span class="comment">% x(0)=0</span></div><div class="line">		ri = <span class="number">2</span>*x(ii) - x(ii+<span class="number">1</span>) + h^<span class="number">2</span>*(x(ii)+ti+<span class="number">1</span>)^<span class="number">3</span>/<span class="number">2</span>;</div><div class="line">	<span class="keyword">else</span></div><div class="line">		ri = <span class="number">2</span>*x(ii) - x(ii<span class="number">-1</span>) - x(ii+<span class="number">1</span>) + h^<span class="number">2</span>*(x(ii)+ti+<span class="number">1</span>)^<span class="number">3</span>/<span class="number">2</span>;</div><div class="line">	<span class="keyword">end</span></div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div><div class="line">21</div><div class="line">22</div><div class="line">23</div><div class="line">24</div><div class="line">25</div><div class="line">26</div></pre></td><td class="code"><pre><div class="line"><span class="comment">%% gdbv: Gradient of discrete boundary value</span></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[grad]</span> = <span class="title">gdbv</span><span class="params">(x)</span></span></div><div class="line">	n = <span class="built_in">length</span>(x);</div><div class="line">	h = <span class="number">1</span>/(n+<span class="number">1</span>);</div><div class="line">	t1 = <span class="number">1</span>*h;  tn = n*h;</div><div class="line">	grad = <span class="built_in">zeros</span>(n, <span class="number">1</span>);</div><div class="line">	grad(<span class="number">1</span>) = (<span class="number">2</span>+<span class="number">3</span>*h^<span class="number">2</span>*(x(<span class="number">1</span>)+t1+<span class="number">1</span>)/<span class="number">2</span>)*<span class="number">2</span>*r_i(<span class="number">1</span>, x) + (<span class="number">-1</span>)*<span class="number">2</span>*r_i(<span class="number">2</span>, x);</div><div class="line">	<span class="keyword">for</span> iter = <span class="number">2</span>:n<span class="number">-1</span></div><div class="line">		ti = iter*h;</div><div class="line">		grad(iter) = (<span class="number">-1</span>)*<span class="number">2</span>*(r_i(iter+<span class="number">1</span>, x) + r_i(iter<span class="number">-1</span>, x)) +...</div><div class="line">					 (<span class="number">2</span>+<span class="number">3</span>*h^<span class="number">2</span>*(x(iter)+ti+<span class="number">1</span>)/<span class="number">2</span>)*<span class="number">2</span>*r_i(iter, x);</div><div class="line">	<span class="keyword">end</span></div><div class="line">	grad(n) = (<span class="number">2</span>+<span class="number">3</span>*h^<span class="number">2</span>*(x(n)+tn+<span class="number">1</span>)/<span class="number">2</span>)*<span class="number">2</span>*r_i(n, x) + (<span class="number">-1</span>)*<span class="number">2</span>*r_i(n<span class="number">-1</span>, x);</div><div class="line"><span class="keyword">end</span></div><div class="line"></div><div class="line"><span class="function"><span class="keyword">function</span> <span class="title">ri</span> = <span class="title">r_i</span><span class="params">(ii, x)</span></span></div><div class="line">	n = <span class="built_in">length</span>(x);</div><div class="line">	x(n+<span class="number">1</span>) = <span class="number">0</span>;</div><div class="line">	h = <span class="number">1</span>/(n+<span class="number">1</span>);</div><div class="line">	ti = ii*h;</div><div class="line">	<span class="keyword">if</span>(ii == <span class="number">1</span>)		<span class="comment">% x(0)=0</span></div><div class="line">		ri = <span class="number">2</span>*x(ii) - x(ii+<span class="number">1</span>) + h^<span class="number">2</span>*(x(ii)+ti+<span class="number">1</span>)^<span class="number">3</span>/<span class="number">2</span>;</div><div class="line">	<span class="keyword">else</span></div><div class="line">		ri = <span class="number">2</span>*x(ii) - x(ii<span class="number">-1</span>) - x(ii+<span class="number">1</span>) + h^<span class="number">2</span>*(x(ii)+ti+<span class="number">1</span>)^<span class="number">3</span>/<span class="number">2</span>;</div><div class="line">	<span class="keyword">end</span></div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<h4 id="SR1，DFP和BFGS方法效果比较"><a href="#SR1，DFP和BFGS方法效果比较" class="headerlink" title="SR1，DFP和BFGS方法效果比较"></a>SR1，DFP和BFGS方法效果比较</h4><p>SR1, DFP 和 BFGS 都是拟牛顿方法，计算步骤相同，只是计算近似矩阵 $H$ 时有不同，故代码写在一处:</p>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div><div class="line">21</div><div class="line">22</div><div class="line">23</div><div class="line">24</div><div class="line">25</div><div class="line">26</div><div class="line">27</div><div class="line">28</div><div class="line">29</div><div class="line">30</div><div class="line">31</div><div class="line">32</div><div class="line">33</div><div class="line">34</div><div class="line">35</div><div class="line">36</div><div class="line">37</div><div class="line">38</div><div class="line">39</div><div class="line">40</div><div class="line">41</div><div class="line">42</div><div class="line">43</div><div class="line">44</div><div class="line">45</div><div class="line">46</div><div class="line">47</div><div class="line">48</div><div class="line">49</div><div class="line">50</div><div class="line">51</div><div class="line">52</div><div class="line">53</div><div class="line">54</div><div class="line">55</div><div class="line">56</div><div class="line">57</div><div class="line">58</div><div class="line">59</div><div class="line">60</div><div class="line">61</div><div class="line">62</div></pre></td><td class="code"><pre><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[x, vals, k]</span> = <span class="title">quasi_newton</span><span class="params">(f, g, xk, method)</span></span></div><div class="line">	<span class="comment">%% Quasi-newton's method</span></div><div class="line">	<span class="comment">% x: result point  val: result value  k: total iterations</span></div><div class="line">	<span class="comment">% f: function to be optimized  g: gradient of f  xk: start point, column vector</span></div><div class="line">	<span class="comment">% hesse: Hesse matrix of f	</span></div><div class="line">	<span class="comment">% method 'SR1', 'DFP', 'BFGS'</span></div><div class="line">	maxiter = <span class="number">200</span>;</div><div class="line">	epsilon = <span class="number">1e-5</span>;</div><div class="line">	</div><div class="line">	x = xk';</div><div class="line">	vals = feval(f, xk);</div><div class="line"></div><div class="line">	<span class="comment">% Iteration 1, steepest descent</span></div><div class="line">	H = <span class="built_in">eye</span>(<span class="built_in">length</span>(xk));</div><div class="line">	grad_k = feval(g, xk); 				<span class="comment">% gk, gradient at xk</span></div><div class="line">	d = -H*grad_k;						<span class="comment">% d1</span></div><div class="line">	[alpha, xk1] = wolfe(f, g, xk, d);</div><div class="line">	grad_k1 = feval(g, xk1);</div><div class="line">	delta_x = xk1 - xk; 				<span class="comment">% s1</span></div><div class="line">	delta_g = grad_k1 - grad_k;			<span class="comment">% y1</span></div><div class="line"></div><div class="line">	<span class="keyword">for</span> iter = <span class="number">1</span>:maxiter</div><div class="line">		<span class="comment">% Record results</span></div><div class="line">        <span class="built_in">disp</span>([<span class="string">'Quasi_newton iteration '</span> num2str(iter)])</div><div class="line">		x = [x; xk1<span class="string">'];</span></div><div class="line">		vals = [vals; feval(f, xk1)];</div><div class="line"></div><div class="line">		if(norm(grad_k1) &lt; epsilon)</div><div class="line">			disp('Optimization done!<span class="string">')</span></div><div class="line">			break;</div><div class="line">		else</div><div class="line">			if (strcmp(method, 'SR1<span class="string">'))</span></div><div class="line">				delt_H = (delta_x - H*delta_g)*(delta_x - H*delta_g)'/((delta_x - H*delta_g)<span class="string">'*delta_g);</span></div><div class="line">				H = H + delt_H;</div><div class="line">			elseif (strcmp(method, 'DFP<span class="string">'))</span></div><div class="line">				delt_H = delta_x*delta_x'/(delta_x<span class="string">'*delta_g) - H*(delta_g*delta_g'</span>)*H/(delta_g<span class="string">'*H*delta_g);</span></div><div class="line">				H = H + delt_H;</div><div class="line">			elseif (strcmp(method, 'BFGS<span class="string">'))</span></div><div class="line">				delt_H = (1 + delta_g'*H*delta_g/(delta_g<span class="string">'*delta_x))*(delta_x*delta_x'</span>)/(delta_g<span class="string">'*delta_x) - ...</span></div><div class="line">						 (delta_x*delta_g'*H + H*delta_g*delta_x<span class="string">')/(delta_g'</span>*delta_x);</div><div class="line">				H = H + delt_H;</div><div class="line">			else</div><div class="line">				error(<span class="string">'Invalid method!'</span>);</div><div class="line">			end</div><div class="line">			d = -H*grad_k1;</div><div class="line">			xk = xk1;</div><div class="line">			[alpha, xk1] = wolfe(f, g, xk1, d);</div><div class="line"></div><div class="line">			<span class="comment">% Prepare for next iteration</span></div><div class="line">			grad_k  = grad_k1;</div><div class="line">			grad_k1 = feval(g, xk1);</div><div class="line">			delta_x = xk1 - xk;</div><div class="line">			delta_g = grad_k1 - grad_k;</div><div class="line">		<span class="keyword">end</span></div><div class="line">	<span class="keyword">end</span></div><div class="line"></div><div class="line">	<span class="keyword">if</span>(iter &gt; maxiter)</div><div class="line">		<span class="built_in">disp</span>([<span class="string">'Can not find answer in '</span> num2str(maxiter) <span class="string">' iterations!'</span>])</div><div class="line">	<span class="keyword">else</span> </div><div class="line">		k = iter;</div><div class="line">	<span class="keyword">end</span></div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<p>实验终止条件都是使用梯度条件: $|g(x_k)| &lt; 1e-5$ ，最大迭代次数400 .</p>
<ul>
<li><p>$watson$ 函数上测试的测试情况(feval 为函数及其导数函数的调用次数)</p>
<p>| $n = 6$     | feval | 迭代次数 | 最终结果   | 备注                                    |<br>| ———– | —– | —- | —— | ————————————- |<br>| SR1(Wolfe)  |      |     | NaN    | wolfe准则搜不到满意步长， iter 12步长太小，出现NaN，无法解 |<br>| SR1(Amijo)  | 803   | 400  | 0.0060 | amijo准则无法搜索到满意步长，迭代到maxiter，没有满足终止条件  |<br>| DFP(Wolfe)  | 671   | 335  | 0.0024 | wolfe准则在满足终止条件前无法找到步长                 |<br>| DFP(Amijo)  | 803   | 400  | 0.0026 | amijo准则迭代到maxiter，没有满足终止条件            |<br>| BFGS(Wolfe) | 601   | 300  | 0.0024 | wolfe准则300次后出现NaN，无法解                 |<br>| BFGS(Amijo) | 803   | 400  | 0.0024 | amijo准则无法搜索到满意步长，迭代到maxiter，没有满足终止条件  |</p>
<p>| $n = 9$     | feval | 迭代次数 | 最终结果      | 备注                                   |<br>| ———– | —– | —- | ——— | ———————————— |<br>| SR1(Wolfe)  | 260   | 129  | 1.3999e-6 |                                      |<br>| SR1(Amijo)  | 803   | 400  | 0.0111    | amijo准则无法搜索到满意步长，迭代到maxiter，没有满足终止条件 |<br>| DFP(Wolfe)  | 803   | 400  | 4.1172e-5 | wolfe迭代到maxiter，没有满足终止条件             |<br>| DFP(Amijo)  | 803   | 400  | 4.9962e-5 | amijo准则无法搜索到满意步长，迭代到maxiter，没有满足终止条件 |<br>| BFGS(Wolfe) | 98    | 48   | 6.6841e-6 |                                      |<br>| BFGS(Amijo) | 803   | 400  | 0.0080    | amijo准则无法搜索到满意步长，迭代到maxiter，没有满足终止条件 |</p>
<p>| $n = 12$    | feval | 迭代次数 | 最终结果      | 备注                                   |<br>| ———– | —– | —- | ——— | ———————————— |<br>| SR1(Wolfe)  |      |     | NaN       | wolfe准则搜不到满意步长，iter 18步长太小，出现NaN，无法解 |<br>| SR1(Amijo)  | 803   | 400  | 0.0116    | amijo准则无法搜索到满意步长，迭代到maxiter，没有满足终止条件 |<br>| DFP(Wolfe)  | 803   | 400  | 5.6117e-6 | wolfe迭代到maxiter，没有满足终止条件             |<br>| DFP(Amijo)  | 803   | 400  | 4.2964e-6 | amijo准则无法搜索到满意步长，迭代到maxiter，没有满足终止条件 |<br>| BFGS(Wolfe) | 84    | 41   | 1.5767e-7 |                                      |<br>| BFGS(Amijo) | 803   | 400  | 0.0019    | amijo准则无法搜索到满意步长，迭代到maxiter，没有满足终止条件 |</p>
<p>结果似乎都不太理想，似乎n=6时终止条件太苛刻，n=12时终止条件又太宽松了。</p>
</li>
</ul>
<ul>
<li><p>$Discrete ~boundary ~value$ 函数上的计算情况</p>
<p>| $n =m= 15$  | feval | 迭代次数 | 最终结果       | 备注                                     |<br>| ———– | —– | —- | ———- | ————————————– |<br>| SR1(Wolfe)  |      |     | NaN        | wolfe准则搜不到满意步长， iter 13时步长太小，出现NaN，无法解 |<br>| SR1(Amijo)  | 38    | 18   | 3.0620e-10 | amijo准则无法搜索到满意步长，但迭代到 iter 18 就满足终止条件  |<br>| DFP(Wolfe)  | 574   | 286  | 1.1134e-11 |                                        |<br>| DFP(Amijo)  | 566   | 282  | 7.5798e-12 | amijo准则无法搜索到满意步长，但迭代到 iter 282 就满足终止条件 |<br>| BFGS(Wolfe) | 54    | 26   | 5.0347e-12 |                                        |<br>| BFGS(Amijo) | 54    | 26   | 4.5023e-11 | amijo准则无法搜索到满意步长，但迭代到 iter 26 就满足终止条件  |</p>
<p>​</p>
</li>
</ul>
<p>[1] Testing Unconstrained Optimization Software</p>
]]></content>
    
    <summary type="html">
    
      &lt;h4 id=&quot;测试函数&quot;&gt;&lt;a href=&quot;#测试函数&quot; class=&quot;headerlink&quot; title=&quot;测试函数&quot;&gt;&lt;/a&gt;测试函数&lt;/h4&gt;&lt;h5 id=&quot;Watson-函数&quot;&gt;&lt;a href=&quot;#Watson-函数&quot; class=&quot;headerlink&quot; title=&quot;Watson 函数&quot;&gt;&lt;/a&gt;Watson 函数&lt;/h5&gt;&lt;p&gt;$$&lt;br&gt;min \sum_{i=1}^{m}r_i^2(x) \\&lt;br&gt;r_i(x) = \sum_{j=2}^n(j-1)x_jt_i^{j-2} - (\sum_{j=1}^nx_jt_i^{j-1})^2 - 1&lt;br&gt;$$&lt;/p&gt;
&lt;p&gt;其中，$t_i=i/29,~ 1 \le i \le 29,~ r_{30}=x_1,~ r_{31} = x_2 - x_1^2 -1,~ 2 \le n \le 31,~ m = 31$ . 初始点选为 $x^{(0)} = (0, \dots ,)^T$. &lt;/p&gt;
    
    </summary>
    
    
      <category term="数值优化" scheme="https://zhangyuygss.github.io/tags/%E6%95%B0%E5%80%BC%E4%BC%98%E5%8C%96/"/>
    
  </entry>
  
  <entry>
    <title>牛顿型方法和非精确搜索</title>
    <link href="https://zhangyuygss.github.io/2017/03/27/%E7%89%9B%E9%A1%BF%E5%9E%8B%E6%96%B9%E6%B3%95/"/>
    <id>https://zhangyuygss.github.io/2017/03/27/牛顿型方法/</id>
    <published>2017-03-27T09:19:11.000Z</published>
    <updated>2017-03-27T16:09:54.715Z</updated>
    
    <content type="html"><![CDATA[<h3 id="牛顿型方法（不包括拟牛顿法）"><a href="#牛顿型方法（不包括拟牛顿法）" class="headerlink" title="牛顿型方法（不包括拟牛顿法）"></a>牛顿型方法（不包括拟牛顿法）</h3><p>基本牛顿法的收敛性是局部的，计算效果受初值点选取影响很大。一方面初始点选取不当可能会导致 $hesse$矩阵不正定，从而无法下降；另一方面即使海赛矩阵正定了，因为它的收敛性只在局部成立，同样不能保证函数值下降。为解决这些问题，可以使用阻尼牛顿法和修正牛顿法。</p>
<a id="more"></a>
<h4 id="1-最速下降法"><a href="#1-最速下降法" class="headerlink" title="1.最速下降法"></a>1.最速下降法</h4><p>最速下降法似乎应该不算牛顿型方法，但是它的思想很重要: 找到函数下降最快的方向，然后按照这个方向迭代就能找到极小值点。后面的牛顿型方法都可以看成变度量意义下的最速下降法，即它们依然是沿着下降最快的方向迭代，只是各自对’下降最快’的定义不同，导致具体下降方法不同。</p>
<p>最速下降法的下降方向直接取负梯度方向: $d_k = -g_k$，这种取迭代方向为负梯度方向的算法称为<em>负梯度方法</em>，当搜索步长 $\alpha$ 采用精确线搜索时，就称其为最速下降法。最速下降法对初始点选取不敏感，即使从一个不太靠近最优解的点出发，它也能产生接近最优点的迭代序列，后面拟牛顿法的第一次迭代就是利用最速下降法先快速靠近最优解。同时该方法只需要计算一阶导信息，实现简单且计算量小。虽然最速下降法在每一步迭代都取当前能采取的最优策略，但贪心的未必是最好的: 它的收敛速度是线性收敛，随着迭代的进行，最速下降法靠近最优点的速度会很慢。</p>
<p>采用精确线搜索时，最速下降法的最优步长为 $\alpha  = \frac{g_k^{T}g_k}{g_k^{T}Gg_k}$ .</p>
<p>下面是负梯度方法的代码(步长确定使用的是非精确搜索<em>amijo</em>准则而非精确搜索)</p>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div><div class="line">21</div><div class="line">22</div><div class="line">23</div><div class="line">24</div><div class="line">25</div><div class="line">26</div><div class="line">27</div><div class="line">28</div><div class="line">29</div><div class="line">30</div><div class="line">31</div><div class="line">32</div><div class="line">33</div><div class="line">34</div><div class="line">35</div><div class="line">36</div><div class="line">37</div><div class="line">38</div><div class="line">39</div><div class="line">40</div><div class="line">41</div><div class="line">42</div><div class="line">43</div><div class="line">44</div><div class="line">45</div><div class="line">46</div></pre></td><td class="code"><pre><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[x, val, k, plotinfo]</span> = <span class="title">steepest_descent</span><span class="params">(f, g, x0)</span></span></div><div class="line">	<span class="comment">%% steepest descent method, line search based on Armijo</span></div><div class="line">	<span class="comment">% x: result point  val: result value  k: iterations used</span></div><div class="line">	<span class="comment">% f: function to be optimized  g: gradient of f  x0: start point</span></div><div class="line">    <span class="comment">%     define them in other function file</span></div><div class="line">	maxiter = <span class="number">5000</span>;</div><div class="line">	epsilon = <span class="number">1e-3</span>;				<span class="comment">% accuracy</span></div><div class="line"></div><div class="line">	rho = <span class="number">0.5</span>; sigma = <span class="number">0.4</span>;		<span class="comment">% paras for Armijo</span></div><div class="line"></div><div class="line">	x1s = <span class="number">0</span>; x2s = <span class="number">0</span>; ys = <span class="number">0</span>;</div><div class="line"></div><div class="line">	<span class="keyword">for</span> iter = <span class="number">1</span>:maxiter</div><div class="line">		f_x0 = feval(f, x0);</div><div class="line">		<span class="built_in">disp</span>([<span class="string">'Iteration '</span> num2str(iter<span class="number">-1</span>) <span class="string">'. f_value: '</span> num2str(f_x0) <span class="string">', current point:'</span>]);</div><div class="line">		<span class="built_in">disp</span>(x0');</div><div class="line">		<span class="comment">% record optimize path</span></div><div class="line">		x1s = [x1s; x0(<span class="number">1</span>)]; x2s = [x2s; x0(<span class="number">2</span>)]; ys = [ys; f_x0];</div><div class="line">		grad = feval(g, x0);</div><div class="line">		<span class="comment">% fval = feval(f, x0);</span></div><div class="line">		<span class="keyword">if</span>(norm(grad) &lt; epsilon)</div><div class="line">			<span class="built_in">disp</span>(<span class="string">'Optimization done!'</span>)</div><div class="line">			x = x0;	val = feval(f, x0); k = iter;</div><div class="line">			<span class="keyword">break</span>;</div><div class="line">		<span class="keyword">else</span></div><div class="line">			m = <span class="number">0</span>; mk = <span class="number">0</span>;</div><div class="line">			<span class="keyword">while</span>(m &lt; <span class="number">20</span>)	<span class="comment">% Amijo search</span></div><div class="line">				<span class="keyword">if</span>(feval(f, x0 + (rho^m)*(-grad)) &lt; feval(f, x0) + (rho^m)*sigma*grad'*(-grad))</div><div class="line">					mk = m; <span class="keyword">break</span>; </div><div class="line">				<span class="keyword">end</span></div><div class="line">				m = m + <span class="number">1</span>;</div><div class="line">			<span class="keyword">end</span></div><div class="line">			<span class="keyword">if</span>(m &gt;= <span class="number">20</span>)</div><div class="line">				<span class="built_in">disp</span>(<span class="string">'Amijo did not find a satisfied answer!'</span>)</div><div class="line">				<span class="comment">% mk = m;</span></div><div class="line">			<span class="keyword">end</span></div><div class="line">			x0 = x0 + (rho^mk)*(-grad);</div><div class="line"></div><div class="line">		<span class="keyword">end</span></div><div class="line">	<span class="keyword">end</span></div><div class="line">	<span class="keyword">if</span>(iter &gt;= <span class="number">5000</span>)</div><div class="line">		<span class="built_in">disp</span>(<span class="string">'Optimization stop early, accuracy not satisfied for 5000 iterations!'</span>)</div><div class="line">		x = x0;	val = feval(f, x0); k = iter;</div><div class="line">	<span class="keyword">end</span></div><div class="line">	plotinfo = [x1s(<span class="number">2</span>:end), x2s(<span class="number">2</span>:end), ys(<span class="number">2</span>:end)];</div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<h4 id="2-阻尼牛顿法"><a href="#2-阻尼牛顿法" class="headerlink" title="2.阻尼牛顿法"></a>2.阻尼牛顿法</h4><p>阻尼牛顿法可以改善基本牛顿法的局部收敛性，它可以保证在 <em>hesse</em> 矩阵正定时，${f_k}$ 单调下降，即使 $k$ 点离最优点较远。可以证明对严格凸函数，采用 Wolfe 准则的阻尼牛顿方法具有全局收敛性。</p>
<p>阻尼牛顿法实现很简单，只是在基本牛顿法方向确定的基础上加上步长 $\alpha$ 的一维线搜索，即迭代公式为 $x_{k+1} = x_k + \alpha_kd_k$ .</p>
<p>代码里只要加上一句非精确搜索就好了:</p>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div></pre></td><td class="code"><pre><div class="line">[mk, x0] = amijo(f, g, x0, d);</div></pre></td></tr></table></figure>
<p><em>amijo</em> 搜索的介绍在本文后面给出。</p>
<h4 id="3-修正牛顿方法"><a href="#3-修正牛顿方法" class="headerlink" title="3.修正牛顿方法"></a>3.修正牛顿方法</h4><p>修正牛顿方法针对可能出现的 <em>hesse</em> 矩阵非正定的情况做出修正。一种方法就是在 <em>hesse</em> 阵 $G_k$ 非正定时将基本牛顿法的方向 $d_k $ 换成负梯度方向；另一种则是修改 $G_k$ 使其正定: $(G_k+v_kI)d = -g_k$ , 即取新的方向为 $d = -(G_k+v_kI)^{-1}g_k$ , 其中 $v_k&gt;0$ , $I$ 是单位阵，确定合适的 $v_k$ 使 $G_k+v_kI$ 正定即可。</p>
<p>下面给出修改海赛阵的代码，代码来自参考[1]书</p>
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div></pre></td><td class="code"><pre><div class="line"><span class="comment">% revised part</span></div><div class="line">muk = norm(grad_x0)^(<span class="number">1</span>+tau);</div><div class="line">Ak = h_x0 + muk*<span class="built_in">eye</span>(<span class="built_in">length</span>(startp));</div><div class="line">d = -Ak\grad_x0;</div></pre></td></tr></table></figure>
<h3 id="非精确搜索"><a href="#非精确搜索" class="headerlink" title="非精确搜索"></a>非精确搜索</h3><p>下面给出两个非精确搜索的代码。分别是 <em>wolfe</em> 准则和 <em>amijo</em> 准则，代码同样非原创。</p>
<h4 id="1-Wolfe"><a href="#1-Wolfe" class="headerlink" title="1.Wolfe"></a>1.Wolfe</h4><figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div><div class="line">21</div><div class="line">22</div><div class="line">23</div><div class="line">24</div><div class="line">25</div><div class="line">26</div><div class="line">27</div></pre></td><td class="code"><pre><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[alpha, x]</span> = <span class="title">wolfe</span><span class="params">(f, g, x0, d)</span></span></div><div class="line">	<span class="comment">%% Weak wolf </span></div><div class="line">	<span class="comment">% Code from internet</span></div><div class="line">	rho  = <span class="number">0.25</span>; sigma = <span class="number">0.75</span>;</div><div class="line">	alpha = <span class="number">1</span>; a = <span class="number">0</span>; b = Inf;</div><div class="line">    k = <span class="number">0</span>;</div><div class="line">	<span class="keyword">while</span>(<span class="number">1</span>)</div><div class="line">        k = k + <span class="number">1</span>;</div><div class="line">        <span class="keyword">if</span> (k &gt; <span class="number">300</span>)</div><div class="line">            <span class="keyword">break</span>;</div><div class="line">        <span class="keyword">end</span></div><div class="line">        <span class="keyword">if</span> (~<span class="built_in">mod</span>(k,<span class="number">100</span>))</div><div class="line">           <span class="built_in">disp</span>([<span class="string">'    Wolf iter'</span> num2str(k)]); </div><div class="line">        <span class="keyword">end</span></div><div class="line">		<span class="keyword">if</span> ~(feval(f, x0+alpha*d) &lt;= feval(f, x0) + rho*alpha*feval(g, x0)'*d)</div><div class="line">			b  = alpha;</div><div class="line">			alpha = (alpha+a)/<span class="number">2</span>;</div><div class="line">			<span class="keyword">continue</span>;</div><div class="line">		<span class="keyword">end</span></div><div class="line">		<span class="keyword">if</span> ~(feval(g, x0+alpha*d)'*d &gt;= sigma*feval(g, x0)'*d)</div><div class="line">			a = alpha;</div><div class="line">			alpha = min([<span class="number">2</span>*alpha, (b+alpha)/<span class="number">2</span>]);</div><div class="line">        <span class="keyword">end</span></div><div class="line">		<span class="keyword">break</span>;</div><div class="line">	<span class="keyword">end</span></div><div class="line">	x = x0 + alpha*d;</div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<h4 id="2-Amijo"><a href="#2-Amijo" class="headerlink" title="2.Amijo"></a>2.Amijo</h4><figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div></pre></td><td class="code"><pre><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[mk, x]</span> = <span class="title">amijo</span><span class="params">(f, g, x0, d)</span></span></div><div class="line">	<span class="comment">%% Amijo condition  </span></div><div class="line">	<span class="comment">% code from book  </span></div><div class="line">	<span class="built_in">beta</span> = <span class="number">0.5</span>; sigma = <span class="number">0.4</span>;</div><div class="line">	m = <span class="number">0</span>; maxiter = <span class="number">20</span>;</div><div class="line">	<span class="keyword">while</span>(m &lt; maxiter)</div><div class="line">		<span class="keyword">if</span>(feval(f, x0+<span class="built_in">beta</span>^m*d) &lt;= feval(f, x0) + sigma*<span class="built_in">beta</span>^m*feval(g, x0)'*d)</div><div class="line">			mk = m; x = x0 + <span class="built_in">beta</span>^mk*d;</div><div class="line">			<span class="keyword">break</span>;</div><div class="line">		<span class="keyword">end</span></div><div class="line">		m = m + <span class="number">1</span>;</div><div class="line">	<span class="keyword">end</span></div><div class="line">	<span class="built_in">disp</span>(<span class="string">'Amijo can not find a satisfied step length in 20 iterations!'</span>)</div><div class="line">	mk = m; x = x0 + <span class="built_in">beta</span>^mk*d;</div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<p>[1]: 最优化方法及其 Matlab 程序设计 马昌凤</p>
]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;牛顿型方法（不包括拟牛顿法）&quot;&gt;&lt;a href=&quot;#牛顿型方法（不包括拟牛顿法）&quot; class=&quot;headerlink&quot; title=&quot;牛顿型方法（不包括拟牛顿法）&quot;&gt;&lt;/a&gt;牛顿型方法（不包括拟牛顿法）&lt;/h3&gt;&lt;p&gt;基本牛顿法的收敛性是局部的，计算效果受初值点选取影响很大。一方面初始点选取不当可能会导致 $hesse$矩阵不正定，从而无法下降；另一方面即使海赛矩阵正定了，因为它的收敛性只在局部成立，同样不能保证函数值下降。为解决这些问题，可以使用阻尼牛顿法和修正牛顿法。&lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>基本牛顿法测试</title>
    <link href="https://zhangyuygss.github.io/2017/03/19/%E5%9F%BA%E6%9C%AC%E7%89%9B%E9%A1%BF%E6%B3%95%E6%B5%8B%E8%AF%95/"/>
    <id>https://zhangyuygss.github.io/2017/03/19/基本牛顿法测试/</id>
    <published>2017-03-19T01:40:31.000Z</published>
    <updated>2017-03-27T11:46:53.115Z</updated>
    
    <content type="html"><![CDATA[<h4 id="基本牛顿方法"><a href="#基本牛顿方法" class="headerlink" title="基本牛顿方法"></a>基本牛顿方法</h4><p>基本牛顿方法, 迭代方向为 $d_k = -G_k^{-1}g_k$, 步长取1. 迭代公式为 $x_k = x_k + d_k$. 因为不能保证 <em>hesse</em> 矩阵正定, 导致无法保证 $d_k$ 为下降方向. 其具有局部收敛性, 即初始点距离最优点必须足够小, 否则迭代序列 $x{k}$ 就会收敛到鞍点或极大点. </p>
<a id="more"></a>
<p>下面用两个不同初始点测试函数<br>$$<br>f(x) = \frac{x_1^4}{12} + \frac{x_1^2}{2} + x_2arctanx_2 - \frac{ln(x_2^2 + 1)}{2}<br>$$</p>
<p>它的一阶导和 <em>hesse</em> 阵分别为<br>$$<br>g(x) = [x_1^2/3 + x_1 ~, ~ arctanx_2 ]’<br>$$</p>
<p>$$<br>G(x) = \begin{bmatrix}<br>x_1^2+1 &amp; 0\\<br>0 &amp; \frac{1}{x_2^2+1}<br>\end{bmatrix}<br>$$</p>
<p>基本牛顿法代码:</p>
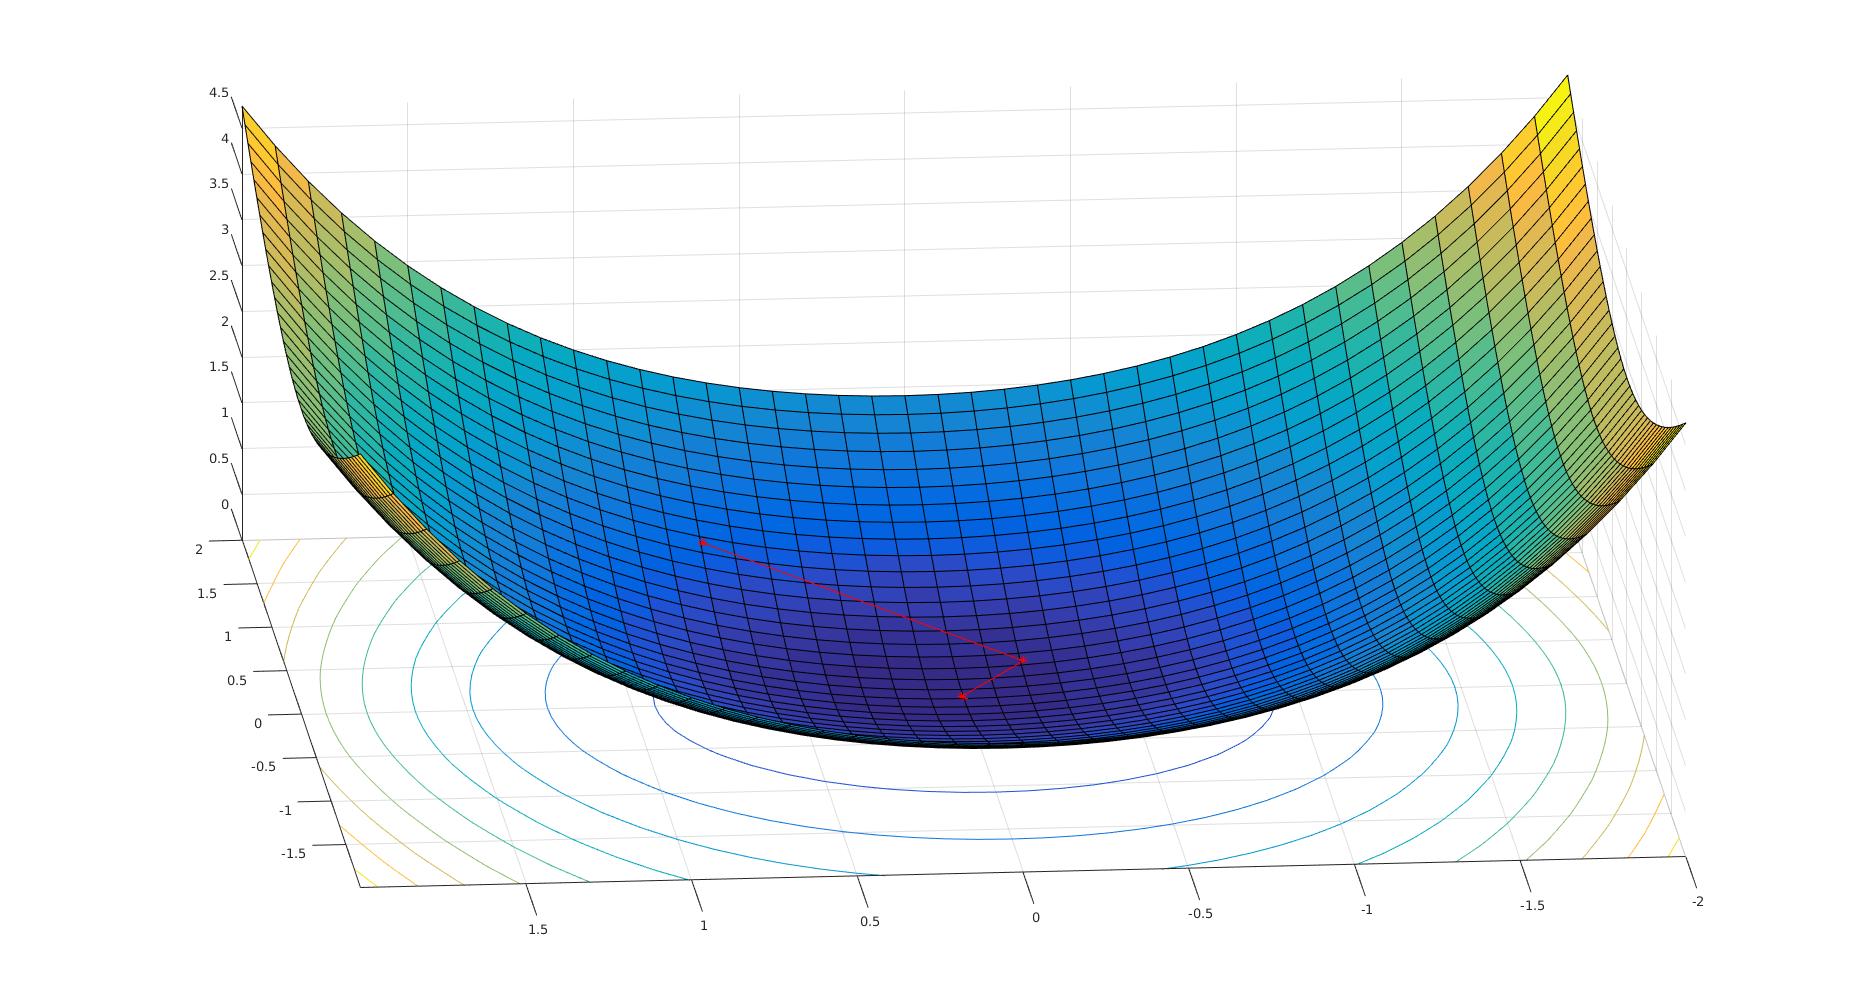
<figure class="highlight matlab"><table><tr><td class="gutter"><pre><div class="line">1</div><div class="line">2</div><div class="line">3</div><div class="line">4</div><div class="line">5</div><div class="line">6</div><div class="line">7</div><div class="line">8</div><div class="line">9</div><div class="line">10</div><div class="line">11</div><div class="line">12</div><div class="line">13</div><div class="line">14</div><div class="line">15</div><div class="line">16</div><div class="line">17</div><div class="line">18</div><div class="line">19</div><div class="line">20</div><div class="line">21</div><div class="line">22</div><div class="line">23</div><div class="line">24</div><div class="line">25</div><div class="line">26</div><div class="line">27</div><div class="line">28</div><div class="line">29</div><div class="line">30</div><div class="line">31</div><div class="line">32</div><div class="line">33</div><div class="line">34</div><div class="line">35</div><div class="line">36</div><div class="line">37</div><div class="line">38</div><div class="line">39</div><div class="line">40</div><div class="line">41</div><div class="line">42</div><div class="line">43</div><div class="line">44</div><div class="line">45</div><div class="line">46</div><div class="line">47</div></pre></td><td class="code"><pre><div class="line"><span class="function"><span class="keyword">function</span> <span class="params">[x, val, k]</span> = <span class="title">newton_basic</span><span class="params">(f, g, hesse, x0, ifplot)</span></span></div><div class="line">	<span class="comment">%% Basic newton's method</span></div><div class="line">	<span class="comment">% x: result point  val: result value  k: total iterations</span></div><div class="line">	<span class="comment">% f: function to be optimized  g: gradient of f  x0: start point, column vector</span></div><div class="line">	<span class="comment">% ifplot: 1, plot figure  hesse: Hesse matrix of f	</span></div><div class="line">	maxiter = <span class="number">500</span>;</div><div class="line">	epsilon = <span class="number">1e-5</span>;</div><div class="line"></div><div class="line">	xs = x0;</div><div class="line">	ys = feval(f, x0);</div><div class="line"></div><div class="line">	<span class="keyword">for</span> iter = <span class="number">1</span>:maxiter</div><div class="line">		f_x0 = feval(f, x0);</div><div class="line">		grad_x0 = feval(g, x0);</div><div class="line">		<span class="comment">% Record optimization</span></div><div class="line">		<span class="keyword">if</span>(iter &gt;= <span class="number">1</span>)</div><div class="line">			xs = [xs; x0<span class="string">'];			</span></div><div class="line">			ys = [ys; f_x0];</div><div class="line">		end</div><div class="line">		disp(['iteration <span class="string">' num2str(iter-1) '</span>  current f: <span class="string">' num2str(f_x0)]);</span></div><div class="line">		if(norm(grad_x0) &lt; epsilon)</div><div class="line">			disp('Optimization done!<span class="string">')</span></div><div class="line">			break;</div><div class="line">		else</div><div class="line">			h_x0 = feval(hesse, x0);</div><div class="line">			d = -inv(h_x0)*grad_x0;</div><div class="line">			x0 = x0 + d;</div><div class="line">		end</div><div class="line">	end</div><div class="line">	x = x0;</div><div class="line">	val = f_x0;</div><div class="line">	k = iter;</div><div class="line"></div><div class="line">	if(ifplot &amp; length(x0)==2)		% Can only plot 2 dimension x variable figures</div><div class="line">		x1 = [x0(1)-2 : 0.1 : x0(1)+2]';</div><div class="line">		x2 = [x0(<span class="number">2</span>)<span class="number">-2</span> : <span class="number">0.1</span> : x0(<span class="number">2</span>)+<span class="number">2</span>]';</div><div class="line">		y = <span class="built_in">zeros</span>(<span class="built_in">length</span>(x1), <span class="built_in">length</span>(x2));</div><div class="line">		<span class="keyword">for</span> ii = <span class="number">1</span>:<span class="built_in">length</span>(x1)</div><div class="line">			<span class="keyword">for</span> jj = <span class="number">1</span>:<span class="built_in">length</span>(x2)</div><div class="line">				y(ii, jj) = feval(f, [x1(ii), x2(jj)]);</div><div class="line">			<span class="keyword">end</span></div><div class="line">		<span class="keyword">end</span></div><div class="line">		surfc(x1, x2, y); hold on;</div><div class="line">		p = plot3(xs(<span class="number">1</span>,:), xs(<span class="number">2</span>,:), ys, <span class="string">'r'</span>);</div><div class="line">		p.Marker = <span class="string">'*'</span>;</div><div class="line">	<span class="keyword">end</span></div><div class="line"><span class="keyword">end</span></div></pre></td></tr></table></figure>
<p>运行代码.</p>
<p>初始点选取 $x^{(0)} = [1, 0.7]’$ 时运行结果:</p>
<table>
<thead>
<tr>
<th style="text-align:center"><em>Iter</em></th>
<th style="text-align:center">$x$</th>
<th style="text-align:center">$f(x)$</th>
</tr>
</thead>
<tbody>
<tr>
<td style="text-align:center">1</td>
<td style="text-align:center">[1, 0.7]’</td>
<td style="text-align:center">0.8115</td>
</tr>
<tr>
<td style="text-align:center">2</td>
<td style="text-align:center">[0.33, -0.21]’</td>
<td style="text-align:center">0.0785</td>
</tr>
<tr>
<td style="text-align:center">3</td>
<td style="text-align:center">[0.02, 0.0061]’</td>
<td style="text-align:center">0.0003</td>
</tr>
<tr>
<td style="text-align:center">4</td>
<td style="text-align:center">[0, 0]</td>
<td style="text-align:center">0</td>
</tr>
</tbody>
</table>
<p>很快收敛到极小值点. 二维变量可以画图，下面画出优化时经过的路径：</p>
<p><img src="https://zhangyuygss.github.io/uploads/basic_newton.jpg" alt="Basic newton"></p>
<p>初始点选取 $x^{(1)} = [1, 2]’$ 时运行结果:</p>
<table>
<thead>
<tr>
<th style="text-align:center"><em>Iter</em></th>
<th style="text-align:center">$x$</th>
<th style="text-align:center">$f(x)$</th>
</tr>
</thead>
<tbody>
<tr>
<td style="text-align:center">1</td>
<td style="text-align:center">[1,2]’</td>
<td style="text-align:center">1.9929</td>
</tr>
<tr>
<td style="text-align:center">2</td>
<td style="text-align:center">[0.33, -3.54]’</td>
<td style="text-align:center">3.3346</td>
</tr>
<tr>
<td style="text-align:center">3</td>
<td style="text-align:center">[0.02, 13.95]’</td>
<td style="text-align:center">18.2780</td>
</tr>
<tr>
<td style="text-align:center">4</td>
<td style="text-align:center">[7e-6, -279.34]’</td>
<td style="text-align:center">432.1602</td>
</tr>
<tr>
<td style="text-align:center">……</td>
</tr>
</tbody>
</table>
<p>函数值随迭代增大, 方法失效.</p>
]]></content>
    
    <summary type="html">
    
      &lt;h4 id=&quot;基本牛顿方法&quot;&gt;&lt;a href=&quot;#基本牛顿方法&quot; class=&quot;headerlink&quot; title=&quot;基本牛顿方法&quot;&gt;&lt;/a&gt;基本牛顿方法&lt;/h4&gt;&lt;p&gt;基本牛顿方法, 迭代方向为 $d_k = -G_k^{-1}g_k$, 步长取1. 迭代公式为 $x_k = x_k + d_k$. 因为不能保证 &lt;em&gt;hesse&lt;/em&gt; 矩阵正定, 导致无法保证 $d_k$ 为下降方向. 其具有局部收敛性, 即初始点距离最优点必须足够小, 否则迭代序列 $x{k}$ 就会收敛到鞍点或极大点. &lt;/p&gt;
    
    </summary>
    
    
  </entry>
  
  <entry>
    <title>Cross-entropy and Softmax relation</title>
    <link href="https://zhangyuygss.github.io/2017/03/12/Cross-entropy-%E4%B8%8E-Softmax/"/>
    <id>https://zhangyuygss.github.io/2017/03/12/Cross-entropy-与-Softmax/</id>
    <published>2017-03-12T08:56:56.000Z</published>
    <updated>2017-03-13T11:21:49.987Z</updated>
    
    <content type="html"><![CDATA[<h1 id="Cross-entropy-交叉熵"><a href="#Cross-entropy-交叉熵" class="headerlink" title="Cross-entropy(交叉熵)"></a>Cross-entropy(交叉熵)</h1><p>信息论要求以最小的成本来传递和表达信息. 比如要给文本编码, 就会给出现次数多的词更短的编码, 而不常见的词的码长会设置的长一些, 这样在传递这份信息时总体需要的码长就会较短. 为了实现这种编码, 需要了解想要描述事物的分布, 这样就和概率分布有了联系, 进而会和机器学习里的问题产生联系.<br><a id="more"></a></p>
<h3 id="Entropy-熵"><a href="#Entropy-熵" class="headerlink" title="Entropy(熵)"></a>Entropy(熵)</h3><p>首先介绍熵的概念. 类似于物理学里用来描述系统混乱程度, 这里的熵用来表示某服从分布 $p$ 的随机变量 $X$ 的不确定程度. 符号表示位 $H(p)$ 或者 $H(X)$. 具体计算公式为:<br>$$<br>H(p) = E(-plog(p))<br>$$</p>
<p>具体如何计算这里的熵:</p>
<ul>
<li>对于离散分布 $p$ : $H(p) = -\sum_{k = 1}^K p(X = k)log(p(X = k))$. 比如伯努利分布的 entropy 为 $H(p) = -(p(X = 0)log(p(X = 0)) + p(X = 1)log(p(X = 1))) \approx 0.69$. (此处 $log$ 取自然底数 $e$)</li>
<li>对于连续分布 $p$ 取相应的积分即可: $H(p) = -\int p(X)log(p(X)) dx$.        </li>
</ul>
<p>从计算公式中可以看出当 $X$ 服从均匀分布时, $H(p)$ 的值会取到最大, 也就是分布最不确定; 当分布 $p$ 在某点处概率为脉冲时, 不确定性最小, $H(p)$ 也最小. </p>
<p>像一开始介绍的那样, 熵可以理解为在分布 $p$ 下表达 $X$ 所需的期望编码长度. </p>
<h3 id="Cross-entropy-交叉熵-1"><a href="#Cross-entropy-交叉熵-1" class="headerlink" title="Cross-entropy(交叉熵)"></a>Cross-entropy(交叉熵)</h3><p>有了熵的概念, 下面介绍交叉熵 <em>cross-entropy</em> . 假如对于 $X$ ,我们有了真实的概率分布 $p$, 就能计算表达 $X$ 需要的编码长度. 这种编码是按照 $X$ 的准确分布量身定制的, 因此是描述 $X$ 的最小编码长度. 而如果我们没有按照分布 $p$ 来表示 $X$, 而采用了另一个估计的概率分布 $q$ 来描述 $X$, 直观上来说, 我们会认为此时需要更多的编码来描述 $X$. 事实上也确实如此. 我们定义交叉熵 $H(p,q)$ 来表示使用错误的分布 $q$ 来表达 $X$ 时需要的平均编码长度:<br>$$<br>H(p,q) = E(-plog(q))<br>$$<br>在离散分布时为: $H(p,q) = - \sum_{k = 1}^K p(X = k)log(q(X = k))$.</p>
<p>做差引入一个重要的概念 <em>KL divergence</em>:<br>$$<br>\begin{aligned}<br>KL(p||q) &amp;= H(p,q) - H(p)\\<br>&amp;= \sum_{k = 1}^K p(X=k)log \frac{p(X = k)}{q(X = k)}\\<br>&amp;\ge 0<br>\end{aligned}<br>$$<br>使用 <em>Jensen 不等式</em> 可以证明(后面给出) <em>KL divergence</em> 一定大于等于0, 也就是使用错误的编码表达 $X$ 时需要耗费更多的编码数. 当且仅当 $p = q$ 时等号成立.</p>
<p>除了表达多用的编码长度外, <em>KL divergence</em> 还有某种意义上的 ‘距离’ 含义, 它表示了两个分布 $p$ 和 $q$ 之间的差别. 相比于表示两个分布之间线性相关性的 <em>相关</em> , KL 距离能够表达 $p$ 和 $q$之间的更多比较信息. </p>
<h3 id="Softmax-Classifier"><a href="#Softmax-Classifier" class="headerlink" title="Softmax Classifier"></a>Softmax Classifier</h3><p>机器学习中的分类器 <em>softmax</em> 使用了 <em>cross-entropy</em>. 该 <em>loss</em> 被广泛应用于神经网络中.</p>
<p>对于 $k$ 个类别的分类问题, 使用线性响应函数 $f(x)_r = w_r^Tx (r = 1,2\cdots k)$ 把样本 $x$ 映射成第 $r$ 个分类上的’’得分’’. 于是若某个样本 $x$属于类别 $j$ , 则得到该样本上的 <em>loss function</em> :<br>$$<br>L = -log\frac{e^{f_j}}{\sum_{i = 1}^k e^{f_i}}<br>$$<br>该损失函数包含  <em>softmax function</em> 的形式,但这个 <em>loss</em> 却经常被称为 <em>cross-entropy loss</em> . 如何理解这样的叫法呢? </p>
<p>首先, 对于样本 $x$ , 它只能属于某一个类别, 也就是它服从真实分布 $p = [0, 0, \cdots , 1(属于第j个类别的概率), \cdots ,0]$. 比值项 $\frac{e^{f_j}}{\sum_{i = 1}^k e^{f_i}}$ 可以看做(注意只是看做, 因为这里计算出的概率数值上并没有很确切的意义, 把它们进行排序得到的 order 相对意义更明确: 属于各个类别的可能性大小的排序)我们模型估计的样本 $x$(属于类别j) 属于 $j$ 的概率, 这个值在真实分布 $p$ 中应该是1, 但是我们的估计值一般是小于1的. 类似我们写出估计出的分布 $q = [\frac{e^{f_1}}{\sum_{i = 1}^k e^{f_i}}, \frac{e^{f_2}}{\sum_{i = 1}^k e^{f_i}}, \cdots ,\frac{e^{f_j}}{\sum_{i = 1}^k e^{f_i}}, \cdots ,\frac{e^{f_k}}{\sum_{i = 1}^k e^{f_i}}]$. </p>
<ul>
<li><p>单纯从概率的角度看, 最小化 <em>loss</em> 的过程就是在最大化$\frac{e^{f_j}}{\sum_{i = 1}^k e^{f_i}}$, 这符合我们的想象. 模型赋予正确分类上的概率越大, 我们自然认为这个模型的估计很合理.</p>
</li>
<li><p>我们也可以从熵的角度来看这个 <em>loss</em> . 很明显, 真实分布 $p$ 和估计分布 $q$ 之间的交叉熵为<br>$$<br>\begin{aligned}<br>H(p,q) &amp;= - \sum_{k = 1}^K p(x = k)log(q(x = k))\\<br>&amp;=-p(x = j)log(q(x=k))\\<br>&amp;= -log \frac{e^{f_j}}{\sum_{i = 1}^k e^{f_i}}\\<br>&amp;= L<br>\end{aligned}<br>$$<br>于是, 当我们最小化 $L$ 时, 我们也相当于在最小化 $p$, $q$ 之间的交叉熵. 而该交叉熵的下界应该是 $H(p)$. 这样我们也可以认为在最小化 $KL(p~||~q) = H(p,q) - H(p)$, 即 $p$ 和 $q$ 之间的 <em>KL divergence</em>. 把它优化得越小, $p$ 和 $q$ 就越接近, 就认为我们估计得越好.</p>
<p>​</p>
</li>
</ul>
]]></content>
    
    <summary type="html">
    
      &lt;h1 id=&quot;Cross-entropy-交叉熵&quot;&gt;&lt;a href=&quot;#Cross-entropy-交叉熵&quot; class=&quot;headerlink&quot; title=&quot;Cross-entropy(交叉熵)&quot;&gt;&lt;/a&gt;Cross-entropy(交叉熵)&lt;/h1&gt;&lt;p&gt;信息论要求以最小的成本来传递和表达信息. 比如要给文本编码, 就会给出现次数多的词更短的编码, 而不常见的词的码长会设置的长一些, 这样在传递这份信息时总体需要的码长就会较短. 为了实现这种编码, 需要了解想要描述事物的分布, 这样就和概率分布有了联系, 进而会和机器学习里的问题产生联系.&lt;br&gt;
    
    </summary>
    
    
  </entry>
  
</feed>